Pendant un incident, chacun veut savoir s'il est touché, ce qu'il doit faire et quand il recevra de nouvelles informations. Une présentation de communication d'incident aide l'équipe à répondre de façon cohérente. Les clients et les dirigeants ne devraient pas avoir à décoder le canal technique de gestion de l'incident.
Considérez ce premier message client pour un service fictif de téléversement de pièces jointes. Toutes les heures, observations et communications ci-dessous sont inventées à titre d'illustration. Elles ne décrivent pas un incident de Presenti.
10:15 UTC — Investigation sur des erreurs de téléversement de pièces jointes
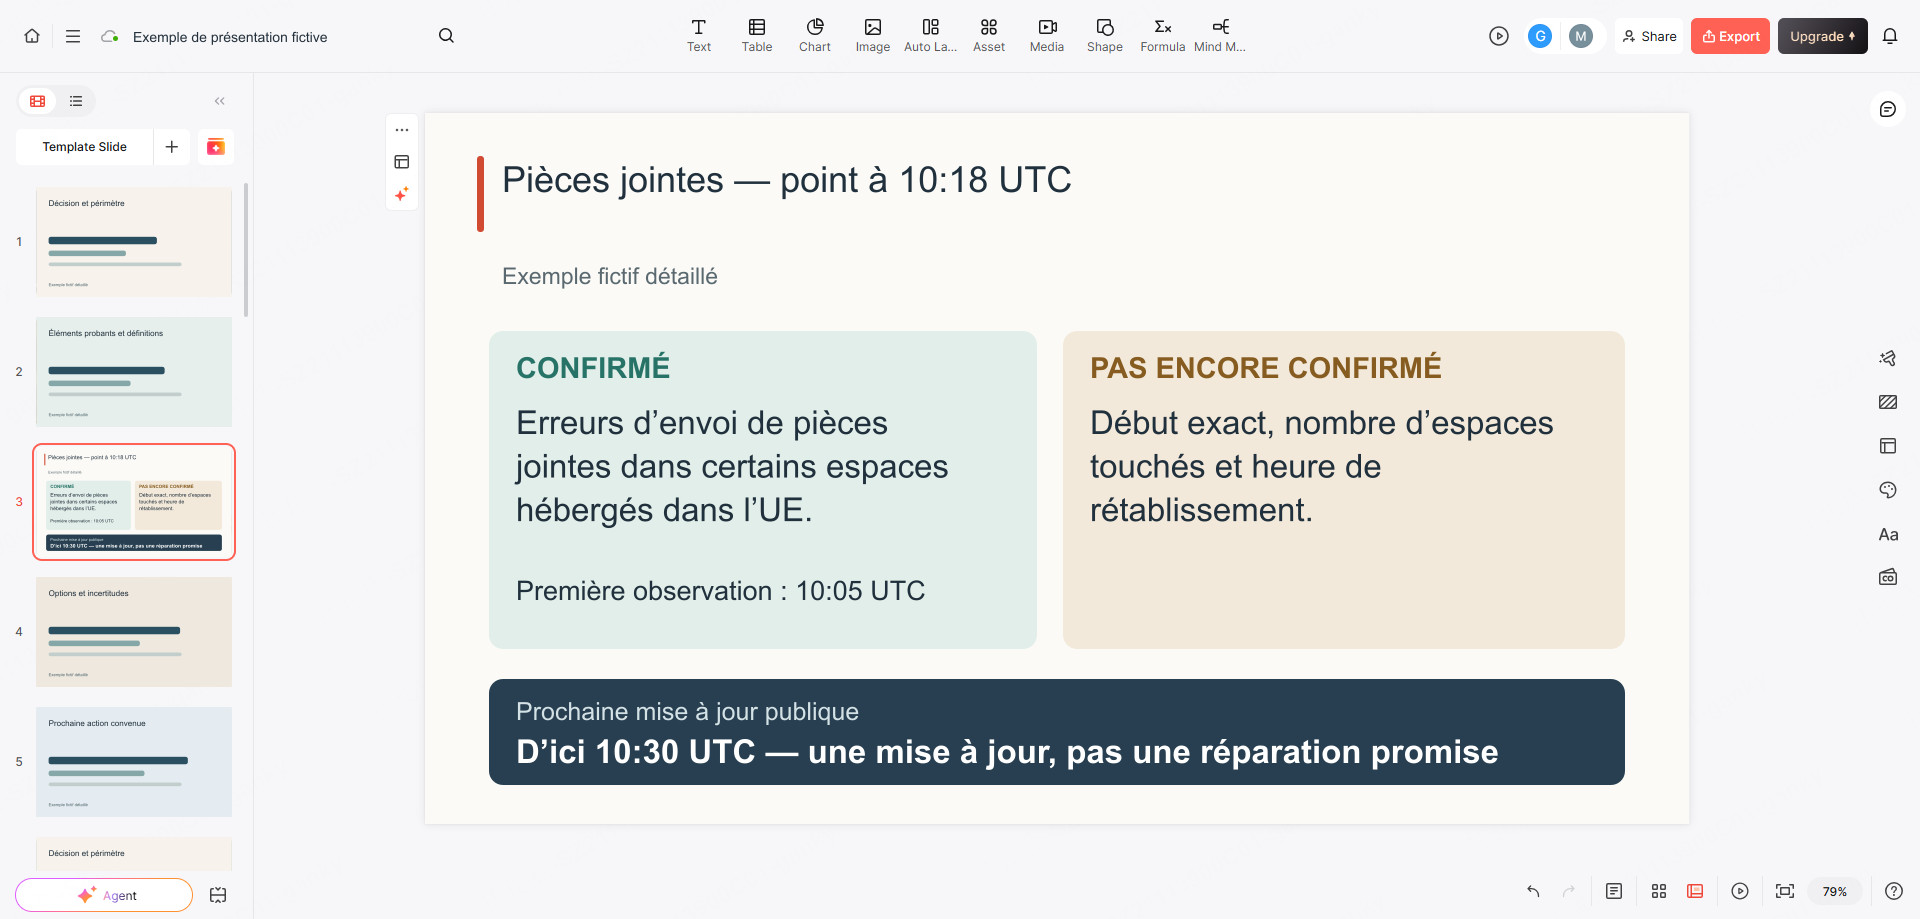
Nous examinons des erreurs affectant les nouveaux téléversements de pièces jointes dans certains espaces de travail hébergés dans notre région UE. Nous avons observé les premières erreurs à 10:05 UTC et déterminons encore l'étendue complète du problème. Nous publierons une nouvelle mise à jour au plus tard à 10:30 UTC.
Le message précise la tâche touchée, le périmètre connu et l'heure du prochain point, sans inventer de cause ni de délai de rétablissement. Construisez votre briefing sur les mêmes faits confirmés. Une fois ces notes approuvées, Presenti peut transformer le texte en présentation modifiable pour les parties prenantes. Il ne surveille pas l'incident, ne vérifie pas le rétablissement et ne publie pas les messages de la page de statut à votre place.
Conserver un relevé commun des faits derrière les différents messages
Avant de concevoir les diapositives, créez un bref relevé d'incident accessible à toutes les personnes qui rédigent une mise à jour. Chaque observation doit avoir une heure et une source. Une hypothèse doit être identifiée comme telle. Une question sans réponse doit rester ouverte tant qu'aucun élément ne permet de la trancher.
Pour l'incident fictif, le relevé de 10:18 UTC pourrait contenir ceci :
| État | Entrée | Élément de preuve ou prochaine action |
|---|---|---|
| Confirmé | Les nouveaux téléversements de pièces jointes renvoient des erreurs pour certains espaces hébergés dans l'UE. | Journaux d'erreurs de la passerelle et test de téléversement échoué depuis un espace touché ; première observation à 10:05 UTC. |
| Confirmé, couverture limitée | Les téléchargements de fichiers existants ont réussi les contrôles effectués jusqu'ici. | Résultats de test enregistrés ; ils ne prouvent pas que tous les téléchargements fonctionnent sans problème pour tous les clients. |
| Inconnu | Heure exacte de début et nombre total d'espaces touchés. | L'exploitation examine les journaux antérieurs et le périmètre des requêtes en échec. |
| Hypothèse | Une modification de routage pourrait être impliquée. | L'équipe du service compare l'historique des changements aux défaillances observées. La proximité temporelle ne démontre pas une cause. |
| Inconnu | Les tentatives ayant expiré ont-elles toutes échoué avant de stocker une pièce jointe ? | Les résultats des requêtes doivent être rapprochés. Ne pas assurer aux clients qu'aucune donnée n'a été perdue ou qu'aucun fichier n'a été stocké. |
Distinguez l'heure exacte de début de celle de la première observation. « Nous avons observé des erreurs pour la première fois à 10:05 » est étayé ici. « L'incident a commencé à 10:05 » ne l'est pas. Cette distinction évite de devoir corriger une affirmation catégorique si des erreurs plus anciennes apparaissent ensuite dans les journaux.
La présentation est un instantané daté de ce relevé, pas une source de vérité concurrente. Inscrivez « État à 10:18 UTC » sur le briefing interne. S'il est transféré une heure plus tard, son ancienneté doit rester évidente.
Donner à chaque public l'information qu'il peut utiliser
Les recommandations de Google sur la réponse aux incidents distinguent le commandement, les opérations et la communication. Elles reconnaissent aussi que clients, support, ingénieurs et dirigeants n'ont pas les mêmes besoins. Servez-vous de cette distinction pour changer l'accent du message, pas les faits.
| Public | Question principale | Contenu de la mise à jour |
|---|---|---|
| Clients | Puis-je accomplir ma tâche et que dois-je faire ? | Fonction et périmètre touchés, action ou contournement confirmé, état courant, heure du prochain point. |
| Support | Comment répondre de façon cohérente et remonter les signalements utiles ? | Message public approuvé, symptômes à reconnaître, promesses à éviter et renseignements de diagnostic à demander. |
| Équipe d'intervention | Que savons-nous, que testons-nous et qui s'en charge ? | Éléments de preuve, hypothèses, actions en cours, responsables, dépendances et décisions techniques ouvertes. |
| Direction | Quelle est l'exposition et attend-on une décision de ma part ? | Impact client connu, ampleur inconnue, responsabilité de la réponse, décisions de ressources ou de communication et heure du prochain briefing. |
Un message client n'a généralement pas besoin d'une théorie sur le routage ; l'équipe d'intervention, oui. La direction doit savoir que le nombre d'espaces touchés reste à établir. Elle ne doit pas recevoir une estimation approximative qui deviendrait un chiffre officiel dès que quelqu'un transmet la diapositive.
Voici un court message interne pour la direction lors du même briefing fictif de 10:18 :
Les nouveaux téléversements de pièces jointes échouent pour certains espaces hébergés dans l'UE. Le nombre d'espaces touchés et l'heure exacte de début ne sont pas encore confirmés. L'équipe du service enquête ; le responsable d'incident prend les décisions d'intervention, et la responsable de la communication coordonne les messages clients et support. Aucune heure de rétablissement n'est approuvée pour communication. Le prochain point client est prévu au plus tard à 10:30 UTC. Aucune décision supplémentaire de la direction n'est demandée à ce stade.
Pour le support, ajoutez une consigne distincte : demander l'identifiant de l'espace, l'heure approximative en UTC et le message d'erreur visible par le canal habituel. Ne demandez pas aux clients de publier des fichiers privés ou des identifiants de connexion sur une page de statut publique. S'il n'existe aucun contournement confirmé, dites-le plutôt que de proposer des manipulations spéculatives.
Montrer la chronologie technique et celle des communications
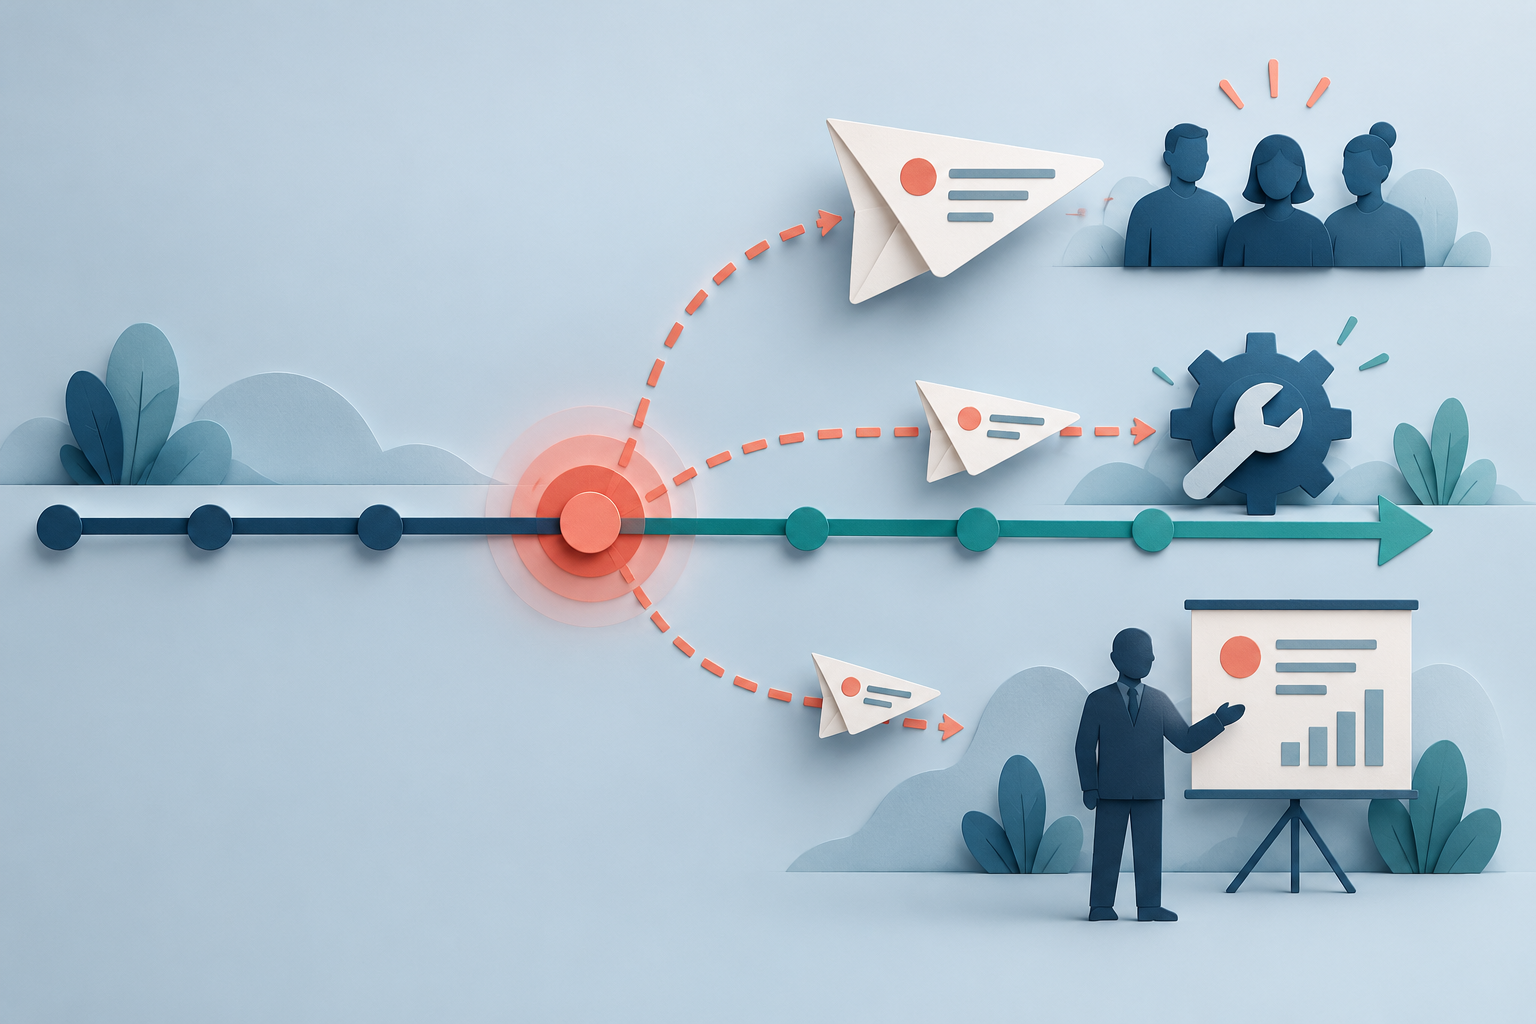
Un événement opérationnel et le message qui le décrit constituent deux enregistrements différents. Une mesure appliquée à 10:42 ne signifie pas que les clients ont été informés à 10:42, ni que le rétablissement était déjà vérifié. Faites apparaître les deux types d'événements dans la chronologie du briefing.
| Heure | Type d'événement | État consigné |
|---|---|---|
| 10:05 | Observation | Premières erreurs de téléversement observées. Début exact encore inconnu. |
| 10:12 | Intervention | Incident déclaré ; responsables de l'incident et de la communication désignés. |
| 10:15 | Mise à jour publique | Investigation annoncée ; prochain point promis au plus tard à 10:30. |
| 10:30 | Mise à jour publique | Rétablissement non confirmé ; investigation en cours ; prochain point au plus tard à 10:50. |
| 10:42 | Intervention | Une mesure d'atténuation est appliquée. Son effet reste à vérifier. |
| 10:50 | Mise à jour publique | Les contrôles récents montrent une amélioration ; le service est sous surveillance ; prochain point au plus tard à 11:15. |
| 11:15 | Mise à jour publique | La disponibilité des téléversements est déclarée rétablie après les contrôles convenus. Le support reste accessible pour les problèmes clients non résolus. |
Ces intervalles sont des exemples, pas une politique universelle. Choisissez une cadence que l'équipe peut réellement tenir, avec des intervalles plus courts lorsque la situation le justifie. Si un changement important survient avant l'heure annoncée, communiquez-le plus tôt.
Promettre une mise à jour ne revient pas à promettre une réparation. Écrivez « prochain point au plus tard à 10:50 UTC », pas « rétabli à 10:50 », sauf si cette seconde affirmation repose sur une base défendable et approuvée. Même si l'enquête n'aboutit à aucune nouvelle conclusion, l'engagement d'informer demeure.
Employer des messages qui restent justes à mesure que l'incident évolue
Le premier accusé de prise en charge rend le problème public. Les messages suivants montrent comment faire progresser la communication sur le même incident fictif sans transformer des indices provisoires en certitudes.
À 10:30 : l'investigation continue
10:30 UTC — Poursuite de l'investigation
Nous continuons d'examiner les erreurs de téléversement de pièces jointes dans certains espaces hébergés dans notre région UE. Nous n'avons pas encore d'heure de rétablissement ni de contournement confirmés. Notre prochaine mise à jour sera publiée au plus tard à 10:50 UTC.
Ce message est utile même sans annoncer de correction. Il confirme que l'incident reste actif et évite de laisser passer silencieusement l'heure promise. Inutile de le remplir de formules telles que « nos ingénieurs travaillent sans relâche » ou de répéter une cause non vérifiée.
À 10:50 : l'amélioration est en cours de vérification
10:50 UTC — Surveillance du rétablissement
Nous avons appliqué une mesure d'atténuation, et les contrôles récents montrent que les téléversements de pièces jointes réussissent de nouveau dans la région touchée. Nous surveillons leurs résultats avant de déclarer le service rétabli. Si vous recevez encore une erreur, contactez le support avec l'identifiant de l'espace et l'heure approximative. Cette page sera mise à jour au plus tard à 11:15 UTC.
« Les contrôles montrent une amélioration » est plus précis et limité que « tout le monde est de nouveau opérationnel ». Conservez cette limite. Le retour d'un graphique à la normale ne règle pas, à lui seul, le résultat des tentatives antérieures et ne prouve pas que tous les parcours clients fonctionnent à nouveau.
À 11:15 : décrire ce qui a été rétabli
11:15 UTC — Disponibilité du téléversement de pièces jointes rétablie
Les téléversements de pièces jointes fonctionnent normalement dans la région touchée. Leurs résultats sont restés dans la plage habituelle du service pendant la période d'observation, et les contrôles convenus ont réussi. Si une tentative antérieure a renvoyé une erreur ou si son résultat est incertain, consultez votre liste de pièces jointes avant de réessayer. Contactez le support si le problème persiste.
Ce dernier message suppose que l'équipe fictive a terminé ces contrôles et confirmé que la consigne convient à son service. Ne le copiez pas dans un incident réel avant de disposer de ces éléments. Il n'affirme ni cause racine, ni nombre exhaustif de clients touchés, ni absence générale de perte de données.
Pour vos propres messages, remplacez la fonction, le périmètre, le symptôme observé, l'état étayé, l'action client et l'heure du prochain point. Ce sont ces éléments qui portent le sens. Changer seulement le nom du service en gardant des formulations de rétablissement non étayées n'est pas une adaptation sûre.
Rendre visibles l'approbation et la prochaine mise à jour
La responsable de la communication a besoin de davantage qu'un paragraphe terminé. Le briefing doit préciser qui confirme les faits techniques, qui approuve le message public et qui le publie par le canal autorisé. Utilisez vos véritables rôles de gestion d'incident ; ne supposez pas que l'auteur des diapositives peut autoriser une déclaration de rétablissement.
Pour le service fictif, cinq diapositives suffiraient :
- État courant : fonction et région touchées, horodatage et responsable actuel de l'incident.
- Impact et incertitude : faits confirmés, inconnues et source de chaque affirmation importante.
- Intervention : actions en cours et décisions attendues, sans présenter une hypothèse non testée comme la cause.
- Communication : message client approuvé, note pour le support, responsable de publication et heure du prochain point.
- Preuves de rétablissement : contrôles requis pour passer de l'investigation à la surveillance ou au rétablissement, avec leurs résultats réels lorsqu'ils sont disponibles.
Distinguez visiblement les formulations en brouillon de celles déjà envoyées. Consignez la version, l'heure d'approbation, l'heure de publication et la destination. Si le périmètre passe de « région UE » à un ensemble plus restreint d'espaces, révisez ensemble le relevé partagé et les messages suivants plutôt que de laisser circuler des diapositives contradictoires.
Les recommandations de Google sur la gestion des incidents insistent sur un relevé à jour et une passation explicite. Pour cette présentation, la conséquence est simple : son propriétaire et son horodatage doivent rester visibles, surtout lors d'un changement d'équipe.
Séparer le service rétabli de l'explication ultérieure
Pendant le rétablissement, indiquez la fonction qui marche de nouveau et les actions encore nécessaires côté client. N'attendez pas une analyse causale complète pour annoncer le retour du service. À l'inverse, ne masquez pas un impact client persistant derrière « résolu » au seul motif qu'une métrique système s'améliore.
Après l'incident, l'équipe peut examiner les facteurs contributifs et les changements de fond dans une présentation de retour d'expérience après incident. Il s'agit d'un autre livrable. Le briefing actif ne doit pas contenir un récit de cause racine inventé simplement pour donner l'impression d'une histoire achevée.
Si la responsable de la communication passe le relais avant la résolution, elle doit laisser un état exploitable. Voici la transmission fictive de 10:35 UTC, entre les mises à jour d'investigation et de surveillance :
Transmission de la communication — 10:35 UTC
État public actuel : investigation sur les erreurs de téléversement de pièces jointes dans certains espaces hébergés dans l'UE. Dernier message : version 2, publié à 10:30 UTC. Prochain point public : au plus tard à 10:50 UTC, y compris un message sans nouvelle conclusion si le rétablissement n'est pas confirmé. La nouvelle responsable de la communication a accepté la prise en charge. Le responsable d'incident confirme l'état opérationnel ; la responsable de la communication publie le texte approuvé. L'heure de rétablissement, le début exact et le nombre d'espaces touchés restent non confirmés. Le relevé partagé contient les derniers éléments de preuve et le message destiné au support.
La personne qui reprend le rôle peut désormais publier le prochain point exact sans reconstruire l'incident à partir de l'historique de discussion ni deviner quelle diapositive est à jour.