Une revue de niveau de service doit expliquer ce que les utilisateurs ont reçu, comment ce résultat se compare à l'objectif convenu et ce que l'équipe doit faire ensuite. Un pourcentage vert ne suffit pas. Le public doit savoir ce qui a été compté, sur quelle période, et si un petit groupe d'utilisateurs a vécu une expérience nettement moins bonne que ne le laisse penser le chiffre principal.
Commencez par une affirmation que l'on peut discuter : « Le service de dépôt de tickets a atteint son objectif de réussite, mais un incident a produit la majorité des échecs. Nous recommandons d'examiner ce chemin de défaillance avant de durcir la cible. » Montrez ensuite le calcul et le parcours touché. C'est une entrée plus utile qu'une capture de tableau de bord avec douze chiffres inexpliqués.
Vous pouvez transformer les notes approuvées en diapositives modifiables avec l'outil de présentation à partir de texte de Presenti. Les preuves doivent venir de vos systèmes de supervision et de support. Presenti aide à organiser et modifier les diapositives ; il ne collecte pas la télémétrie du service et ne détermine pas si un SLO a été atteint.
Définir le service, la mesure et la période
Délimitez précisément la revue : un parcours utilisateur, le service qui le prend en charge et la fenêtre de reporting. « Fiabilité de la plateforme » est trop large si les données ne couvrent que les dépôts de tickets. Une soumission réussie ne démontre pas que la connexion, la recherche et les notifications ont également fonctionné.
Trois termes doivent figurer sur la première diapositive de résultats, ou dans un petit glossaire adjacent. L'explication des objectifs de niveau de service par Google SRE distingue la mesure, la cible et l'accord :
| Terme | Sens | Élément à montrer |
|---|---|---|
| SLI : indicateur de niveau de service | Mesure quantitative du comportement d'un service. | Résultat mesuré et méthode de calcul. |
| SLO : objectif de niveau de service | Cible de cet indicateur sur une période définie. | Seuil convenu, périmètre et fenêtre temporelle. |
| SLA : accord de niveau de service | Accord prévoyant des conséquences si ses engagements de service ne sont pas respectés. | Accord applicable et ses propres modalités de mesure, si la performance contractuelle entre dans le périmètre. |
N'étiquetez pas le résultat d'un SLO interne « conformité au SLA » simplement parce que les pourcentages se ressemblent. L'accord peut avoir un autre périmètre, d'autres exclusions ou une autre période de calcul. Séparez le résultat opérationnel de l'évaluation contractuelle : une diapositive ne suffit pas à établir un manquement contractuel ou un droit à un avoir.
Exemple chiffré : un service de dépôt de tickets
Le service, les enregistrements et les chiffres suivants sont fictifs. Ils illustrent la construction de la revue ; ce ne sont ni des données de performance de Presenti ni une étude de cas client.
Une plateforme de support examine si les clients ont pu déposer de nouveaux tickets. Son SLO de réussite convenu est de 99,90 % sur cette période fixe de 28 jours. La fiche de mesure ci-dessous doit être placée à côté du résultat, pas dans une annexe cachée.
| Rubrique | Définition retenue dans l'exemple |
|---|---|
| Parcours utilisateur | Déposer un nouveau ticket de support et recevoir un identifiant de ticket utilisable. |
| Fenêtre | Du 1er septembre à 00:00 UTC inclus au 29 septembre à 00:00 UTC exclu : 28 jours complets. |
| Événement admissible | Tentative de dépôt authentifiée, bien formée, en production, admise par la passerelle. Chaque tentative possède son propre identifiant de requête. |
| Événement réussi | Le ticket est stocké et le client qui l'a soumis reçoit un identifiant de ticket utilisable. |
| Trafic exclu | Contrôles de santé, trafic de test identifié et requêtes ne respectant pas les règles d'admissibilité convenues. Ces règles ont été fixées avant la période. |
| Éléments de preuve | Export figé de la passerelle rapproché des résultats du service par identifiant de requête ; version de la requête et heure d'extraction jointes à la présentation. |
| Limite de couverture | Les défaillances survenant avant qu'une requête atteigne la passerelle ne sont pas mesurées par ce SLI. |
Le dénominateur compte des tentatives, pas des clients. Une nouvelle tentative constitue un nouvel événement selon cette définition. Si un client effectue dix tentatives au total, la revue contient dix événements, pas dix clients touchés. Conservez cette distinction dans les légendes comme dans les notes de présentation.
La limite de couverture compte aussi. Une page de connexion défaillante pourrait empêcher les clients d'atteindre la passerelle alors que ce SLI reste bon. Montrez cet angle mort à côté du résultat et utilisez d'autres preuves pour le parcours plus large. N'améliorez pas le pourcentage en excluant des requêtes échouées après la fin de la période.
Montrer le calcul du budget d'erreur, pas seulement sa couleur
Les recommandations de Google pour mettre en œuvre les SLO décrivent les indicateurs événementiels comme le nombre d'événements réussis divisé par le total. Pour une cible inférieure à 100 %, l'écart donne la proportion d'événements défaillants autorisée. Voici le calcul pour notre période d'exemple terminée.
| Grandeur | Calcul | Résultat |
|---|---|---|
| Tentatives admissibles | Nombre d'identifiants de requête dans le périmètre | 2 000 000 |
| Tentatives réussies | Résultats réussis confirmés | 1 998 600 |
| Tentatives échouées | 2 000 000 − 1 998 600 | 1 400 |
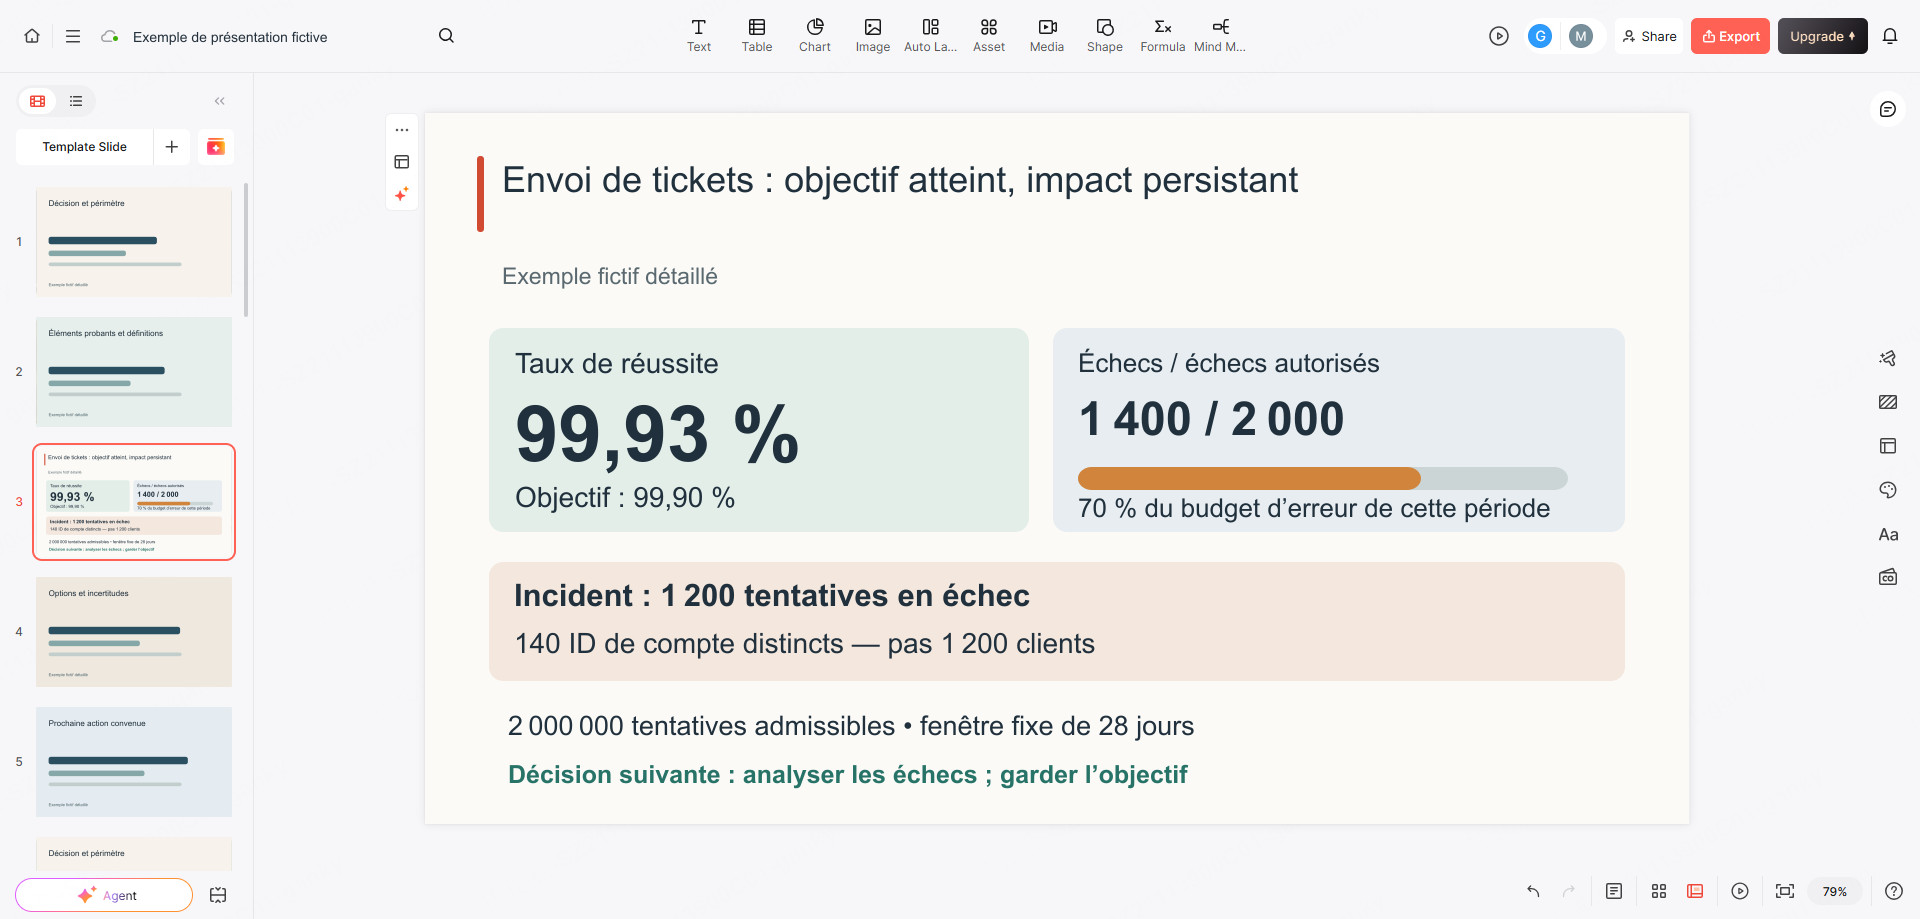
| Taux de réussite mesuré | 1 998 600 ÷ 2 000 000 × 100 | 99,93 % |
| Échecs autorisés | 2 000 000 × (1 − 0,9990) | 2 000 |
| Budget consommé | 1 400 ÷ 2 000 × 100 | 70 % |
| Marge inutilisée sur la période | 2 000 − 1 400 | 600 tentatives |
L'objectif de réussite a été atteint : 99,93 % est supérieur à 99,90 %. La marge est de 0,03 point de pourcentage. L'équipe a consommé 70 % des échecs autorisés, pas 70 % de toutes les requêtes.
Nommez soigneusement les 600 tentatives restantes. Elles concernent la période close ; elles ne donnent pas le droit de provoquer 600 échecs le mois suivant. Un SLO de production glissant nécessite son propre calcul sur la fenêtre courante. De même, un budget d'événements n'est pas une durée d'indisponibilité en minutes. Une minute de trafic intense et une minute de faible trafic peuvent produire des nombres d'échecs très différents.
Conservez les valeurs non arrondies dans la feuille source et utilisez un arrondi cohérent dans les diapositives. Près du seuil, évitez de transformer un objectif manqué en réussite apparente par arrondi. Gardez la requête et la fenêtre associées à la diapositive pour qu'une autre personne puisse reproduire le résultat.
Ajouter un objectif quand une réponse réussie peut rester trop lente
Prolongeons la même revue fictive avec une seconde question : le client a-t-il reçu son identifiant de ticket utilisable en deux secondes au plus ? Une requête peut finir par réussir tout en laissant le client attendre. Présentez les deux résultats côte à côte, au lieu de laisser le bon taux de réussite résumer toute l’expérience.
Dans cet exemple, les deux indicateurs portent sur les mêmes 2 000 000 de tentatives admissibles et sur la même période terminée de 28 jours. Le premier compte les tentatives qui répondent à la définition initiale d’un événement réussi. L’indicateur de réussite dans le délai ne compte une tentative comme bonne que si elle réussit en deux secondes au plus. Son objectif convenu est de 99,00 %. Les tentatives échouées restent dans ce second dénominateur et comptent comme des événements défaillants ; elles ne sont pas retirées pour améliorer artificiellement le résultat de temps de réponse.
| Indicateur | Bonnes tentatives / tentatives admissibles | Résultat et objectif | Budget d’erreur consommé |
|---|---|---|---|
| Dépôt réussi | 1 998 600 / 2 000 000 | 99,93 % ; objectif de 99,90 % atteint | 1 400 défaillances / 2 000 autorisées = 70 % |
| Dépôt réussi en deux secondes au plus | 1 976 000 / 2 000 000 | 98,80 % ; objectif de 99,00 % manqué | 24 000 défaillances / 20 000 autorisées = 120 % |
Les deux lignes se raccordent : 1 998 600 tentatives réussies moins 1 976 000 réussites dans le délai donnent 22 600 tentatives réussies mais lentes. En ajoutant les 1 400 échecs, on obtient 24 000 événements défaillants pour l’objectif de réussite dans le délai, soit 4 000 de plus que le budget autorisé. Un même échec peut compter contre les deux objectifs : leurs populations se recoupent. Additionner leurs totaux de défaillances compterait donc certaines requêtes deux fois.
Un titre utile serait : « Le dépôt a atteint son objectif de réussite, mais pas celui de confirmation dans le délai. » Gardez les deux seuils et les deux définitions visibles. Ne faites pas la moyenne de 99,93 % et de 98,80 % pour obtenir une note de service : elle n’a aucun sens convenu dans cet exemple. Si votre mesure réelle de latence porte uniquement sur les requêtes réussies, indiquez explicitement ce dénominateur différent et ne la comparez pas comme si elle utilisait la même population.
L’action suivante est maintenant mieux ciblée. Séparez les 22 600 réussites lentes des tentatives échouées, puis examinez quand et où chaque groupe est apparu. La revue n’a pas établi que l’incident précédent avait causé les réponses lentes. Demandez au responsable du service d’apporter la distribution des temps de réponse et les parcours touchés à la prochaine revue, avant de proposer une mesure d’atténuation ou de modifier un objectif. Le calcul initial du budget d’erreur reste valable ; le second indicateur explique pourquoi il ne clôt pas la discussion.
Expliquer qui a subi les défaillances
Dans les données fictives, un incident représente 1 200 des 1 400 tentatives échouées. Ces 1 200 tentatives sont associées à 140 identifiants de compte distincts. L'incident a donc consommé 60 % du budget d'erreur total de la période : 1 200 divisés par 2 000. Les 200 autres échecs ont consommé 10 % supplémentaires.
La diapositive d'impact peut ainsi titrer : « Un incident a consommé l'essentiel du budget d'erreur et touché 140 comptes. » Les données ne permettent pas d'affirmer « 140 personnes n'ont pas pu travailler » ou « 1 200 tickets ont été perdus ». Un compte peut avoir plusieurs utilisateurs, des tentatives répétées peuvent concerner un même ticket souhaité, et le nombre d'échecs ne dit pas si le ticket a finalement été créé.
Montrez le parcours touché à côté du décompte. Dans cet exemple, les clients n'obtenaient pas de confirmation de ticket de manière fiable pendant l'incident. Les échanges avec le support peuvent éclairer leurs actions suivantes, mais quelques conversations ne justifient pas une conclusion sur tous les comptes touchés.
Un petit encadré d'impact peut contenir trois lignes :
- Observé : 1 200 tentatives échouées liées à l'incident ; 140 identifiants de compte distincts dans ces données.
- Non encore établi : combien de tickets souhaités ont été abandonnés plutôt que soumis à nouveau avec succès.
- Suite : rapprocher les tentatives de la création finale des tickets avant de communiquer un nombre d'abandons.
C'est pourquoi résultat global et impact utilisateur doivent être présentés ensemble. Le respect de l'objectif répond à une question ; une perturbation concentrée sur un parcours précis en soulève une autre. Aucun ne doit effacer l'autre.
Transformer le résultat en décision de fiabilité
La revue n'est pas un concours visant à choisir la cible la plus élevée possible. Demandez quelle action traite le problème observé, quelles preuves la soutiennent et quel travail devra être reporté. Proposer de passer de 99,90 % à 99,99 % n'améliore pas en soi le service.
Dans l'exemple, le responsable du service peut comparer ces options :
| Option | Problème traité | Preuves requises avant un engagement plus large |
|---|---|---|
| Examiner le parcours à l'origine de la majorité des échecs | L'incident responsable de 1 200 tentatives échouées. | Défaillance reproductible et test comparant les atténuations possibles ; ne pas déduire une cause de la seule chronologie. |
| Étendre la mesure avant la passerelle | L'angle mort entre le navigateur du client et le SLI actuel. | Proposition délimitée précisant la couverture, le traitement des données et l'effort de mise en œuvre. |
| Durcir le SLO immédiatement | Un engagement de fiabilité plus strict. | Preuves que la nouvelle cible correspond aux besoins et plan convenu pour le travail de fiabilité supplémentaire. |
Les deux premières options répondent à des constats précis. La troisième demande une décision distincte sur les attentes et le coût. N'abaissez pas discrètement la cible pour rendre le rapport vert et ne la relevez pas seulement pour donner une allure ambitieuse à la présentation.
Si votre organisation possède déjà une politique de budget d'erreur, indiquez l'action qu'elle impose et qui peut approuver une exception. Sinon, présentez toute politique envisagée comme une proposition. L'auteur des diapositives ne doit pas inventer un gel automatique des mises en production en laissant croire qu'il a déjà été accepté.
Construire une revue en six diapositives exploitable après la réunion
La présentation principale peut rester courte puisque les détails se trouvent dans le dossier de preuves. Donnez une fonction à chaque diapositive :
- Résultat et décision : 99,93 % de réussite contre 99,90 % ; un incident à l'origine de la plupart des échecs ; le travail précis à autoriser.
- Périmètre de mesure : parcours, dates, événements admissibles et réussis, source et angle mort.
- Budget : numérateur, dénominateur, échecs autorisés et calcul des 70 % consommés.
- Impact utilisateur : parcours touché, 140 identifiants de compte observés et inconnues.
- Options : actions concurrentes, preuves requises pour chacune et travail qu'elles remplaceraient.
- Décision consignée : responsable, périmètre approuvé, prochain point de revue et preuves attendues à cette échéance.
Conservez les exports de métriques et les détails de requêtes avec la présentation, sans copier de données personnelles de clients dans les diapositives. Pour un public plus large, utilisez une synthèse d'impact expurgée. Si une définition doit changer, présentez-la comme une version future et laissez le résultat actuel attaché à la définition qui l'a produit.
Voici ce que pourrait contenir la décision de la réunion fictive :
Approuver une investigation de deux jours-ingénieur sur le chemin de défaillance de la confirmation de ticket, sous la responsabilité du responsable du service. Présenter ensuite une reproduction, des options d'atténuation et des résultats de test ; aucune baisse future des échecs n'est encore revendiquée. Maintenir le SLO de réussite à 99,90 %. À la prochaine revue, présenter aussi une proposition délimitée pour mesurer les échecs de soumission avant la passerelle. Toute mise en œuvre au-delà de l'investigation exige une décision de capacité séparée.
Ce compte rendu donne un point de départ concret à la réunion suivante. L'équipe examinera les preuves issues d'un travail défini, au lieu de présenter de nouveau le même pourcentage vert et de répéter la même promesse.