Während einer Störung möchten Menschen wissen, ob sie betroffen sind, was sie tun sollen und wann sie neue Informationen erhalten. Eine Präsentation zur Störungskommunikation hilft dem Team, darauf konsistente Antworten zu geben. Kunden und Führungskräfte sollten dafür nicht den technischen Incident-Kanal entschlüsseln müssen.
Betrachten Sie diese erste Kundenmeldung zu einem fiktiven Dienst zum Hochladen von Anhängen. Alle Uhrzeiten, Beobachtungen und Nachrichten im folgenden Beispiel sind erfunden. Sie beschreiben keinen Vorfall bei Presenti.
10:15 UTC – Fehler beim Hochladen von Anhängen werden untersucht
Wir untersuchen Fehler bei neuen Anhang-Uploads in einigen Workspaces unserer EU-Region. Die Fehler wurden erstmals um 10:05 UTC beobachtet; wir ermitteln noch den vollständigen Umfang. Bis 10:30 UTC veröffentlichen wir ein weiteres Update.
Diese Meldung nennt die betroffene Aufgabe, den bekannten Umfang und den nächsten Informationszeitpunkt, ohne eine Ursache oder Wiederherstellungszeit zu erfinden. Bauen Sie Ihr Briefing auf denselben bestätigten Fakten auf. Sobald die Notizen freigegeben sind, können Sie mit Presenti aus dem Text eine bearbeitbare Präsentation erstellen. Presenti überwacht den Vorfall nicht, bestätigt keine Wiederherstellung und veröffentlicht auch keine Statusmeldungen für Sie.
Einen gemeinsamen Faktenstand hinter allen Meldungen führen
Legen Sie vor dem Foliendesign ein kurzes Vorfallsprotokoll an, auf das alle Verfasser von Updates zugreifen können. Jede Beobachtung braucht einen Zeitpunkt und eine Quelle. Hypothesen müssen als solche erkennbar sein. Eine offene Frage bleibt offen, bis jemand Belege vorlegt.
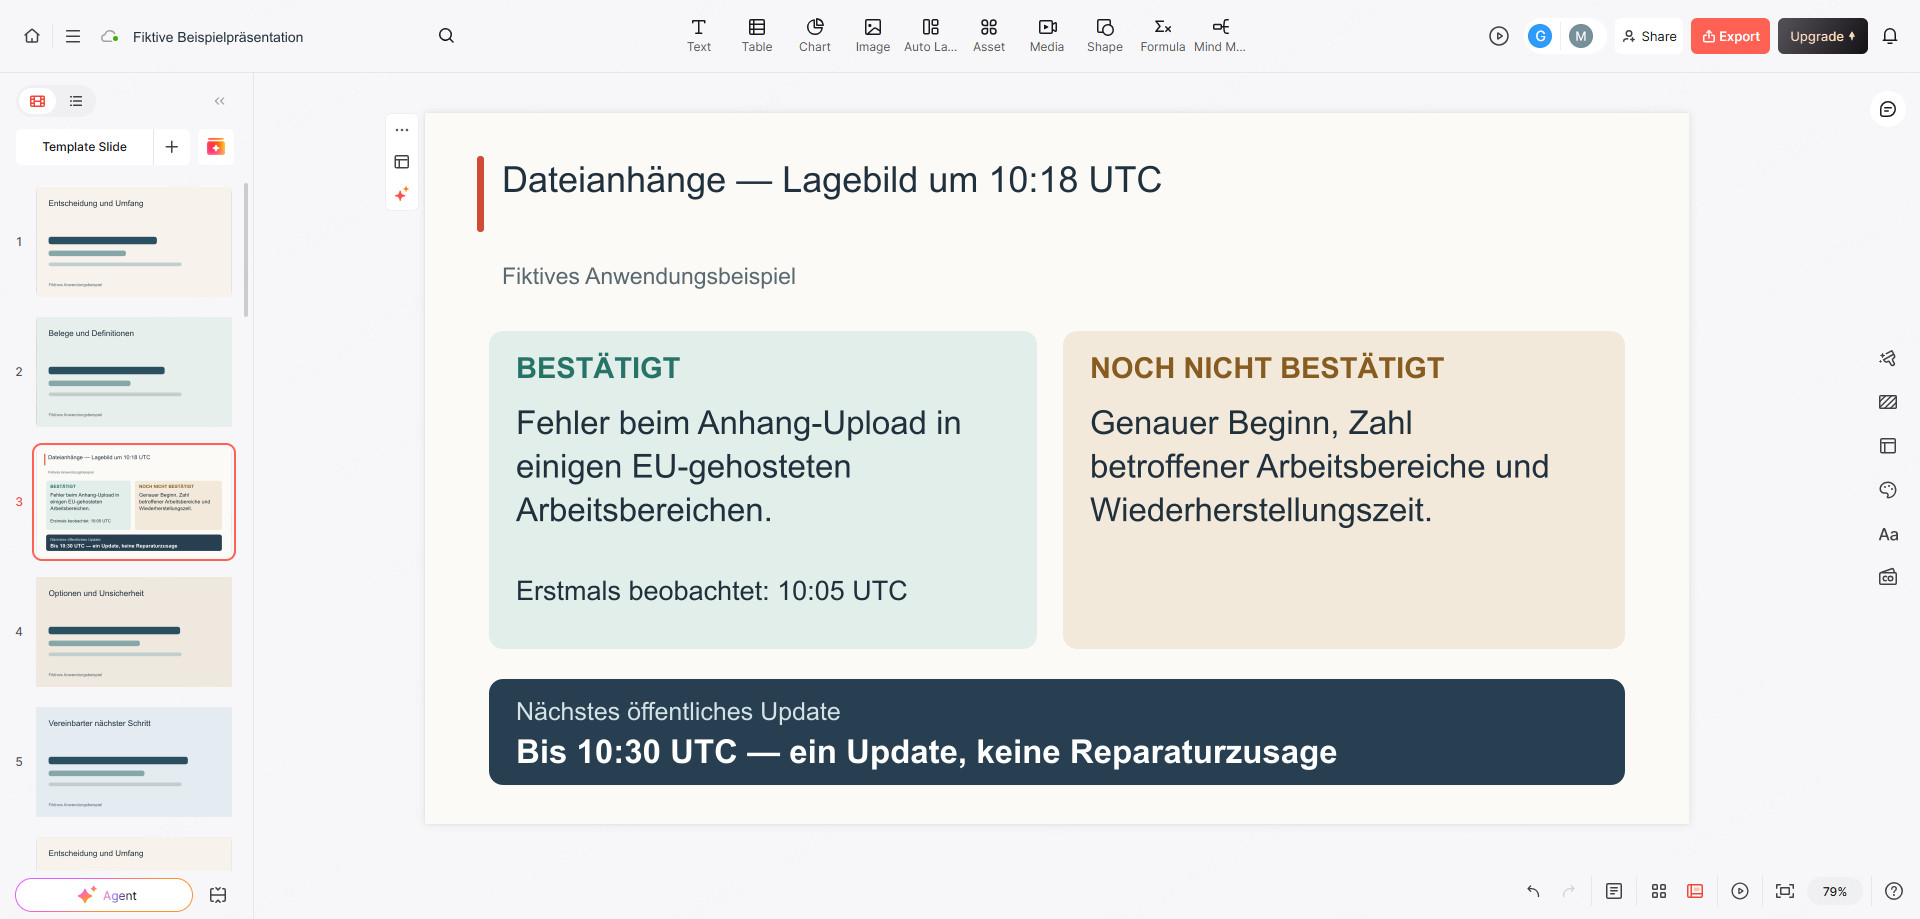
Für den fiktiven Vorfall könnte der Stand um 10:18 UTC so aussehen:
| Status | Eintrag | Beleg oder nächste Maßnahme |
|---|---|---|
| Bestätigt | Neue Anhang-Uploads liefern in einigen EU-gehosteten Workspaces Fehler. | Gateway-Fehlerprotokolle und ein fehlgeschlagener Upload-Test in einem betroffenen Workspace; erstmals um 10:05 UTC beobachtet. |
| Bestätigt, begrenzte Abdeckung | Downloads bestehender Dateien haben die bisherigen Prüfungen bestanden. | Dokumentierte Testergebnisse; sie beweisen nicht, dass jeder Download bei jedem Kunden unbeeinträchtigt ist. |
| Unbekannt | Genauer Beginn und Gesamtzahl betroffener Workspaces. | Der Betrieb prüft frühere Protokolle und den Umfang fehlgeschlagener Anfragen. |
| Hypothese | Eine Routing-Änderung könnte beteiligt sein. | Das Serviceteam vergleicht die Änderungshistorie mit den beobachteten Fehlern. Zeitliche Nähe allein beweist keine Ursache. |
| Unbekannt | Ob sämtliche Upload-Versuche mit Zeitüberschreitung vor dem Speichern des Anhangs scheiterten. | Die Ergebnisse der Anfragen müssen abgeglichen werden. Kunden weder zusichern, dass keine Daten verloren gingen, noch dass nichts gespeichert wurde. |
Trennen Sie den tatsächlichen Beginn vom Zeitpunkt der ersten Beobachtung. „Wir haben um 10:05 erstmals Fehler beobachtet“ ist hier belegt. „Die Störung begann um 10:05“ ist es nicht. So müssen Sie keine zuvor sichere Behauptung zurücknehmen, wenn später frühere Fehler in den Protokollen auftauchen.
Die Präsentation ist eine datierte Momentaufnahme dieses Protokolls, keine konkurrierende Wahrheit. Schreiben Sie „Stand: 10:18 UTC“ auf das interne Briefing. Wird es eine Stunde später weitergeleitet, muss sein Alter erkennbar bleiben.
Jeder Zielgruppe die für sie nutzbaren Informationen geben
Die Google-Leitlinien zur Incident Response trennen Einsatzleitung, operative Bearbeitung und Kommunikation. Sie berücksichtigen außerdem, dass Kunden, Support, Entwicklung und Führungskräfte unterschiedliche Informationen benötigen. Ändern Sie deshalb die Gewichtung – nicht die Fakten.
| Zielgruppe | Wichtigste Frage | Inhalt des Updates |
|---|---|---|
| Kunden | Kann ich meine Aufgabe erledigen, und was soll ich tun? | Betroffene Funktion und Umfang, bestätigte Handlungsempfehlung oder Umgehungslösung, aktueller Status, nächster Update-Zeitpunkt. |
| Support | Wie antworte ich einheitlich und leite nützliche Meldungen weiter? | Freigegebener öffentlicher Text, erkennbare Symptome, unzulässige Zusagen und anzufordernde Diagnosedetails. |
| Bearbeitungsteam | Was wissen wir, was wird geprüft, und wer arbeitet daran? | Belege, Hypothesen, aktuelle Maßnahmen, Verantwortliche, Abhängigkeiten und offene technische Entscheidungen. |
| Führungskräfte | Wie groß ist die Belastung, und muss ich etwas entscheiden? | Bekannte Kundenfolgen, noch unbekannter Umfang, Einsatzverantwortung, Ressourcen- oder Kommunikationsentscheidungen und nächstes Briefing. |
Eine Kundenmeldung braucht meist keine Routing-Theorie; das Bearbeitungsteam schon. Führungskräfte müssen wissen, dass die Zahl betroffener Workspaces noch ermittelt wird. Eine grobe Schätzung auf der Folie könnte durch Weiterleiten unbeabsichtigt zur offiziellen Zahl werden.
Für dasselbe fiktive Briefing um 10:18 könnte eine kurze interne Führungsmeldung so lauten:
Neue Anhang-Uploads schlagen in einigen EU-gehosteten Workspaces fehl. Die Zahl betroffener Workspaces und der genaue Beginn sind noch nicht bestätigt. Das Serviceteam untersucht den Vorfall. Die Incident-Leitung verantwortet die Einsatzentscheidungen; die Kommunikationsverantwortliche koordiniert Kunden- und Supportmeldungen. Eine Wiederherstellungszeit ist nicht zur Kommunikation freigegeben. Das nächste Kundenupdate ist bis 10:30 UTC fällig. Derzeit wird keine zusätzliche Entscheidung der Führungsebene benötigt.
Für den Support ergänzen Sie eine eigene Anweisung: Workspace-Kennung, ungefähren UTC-Zeitpunkt und sichtbare Fehlermeldung über den üblichen Supportkanal erfragen. Kunden sollen keine privaten Dateien oder Zugangsdaten auf einer öffentlichen Statusseite veröffentlichen. Gibt es keine bestätigte Umgehungslösung, sagen Sie das ausdrücklich, statt spekulative Schritte zu empfehlen.
Technische Ereignisse und Kommunikation getrennt auf der Zeitleiste zeigen
Ein Betriebsereignis und die Nachricht darüber sind unterschiedliche Einträge. Eine um 10:42 angewandte Gegenmaßnahme bedeutet weder, dass Kunden um 10:42 informiert wurden, noch dass die Wiederherstellung bereits geprüft war. Nehmen Sie beide Ereignisarten in die Briefing-Zeitleiste auf.
| Zeit | Ereignisart | Protokollierter Stand |
|---|---|---|
| 10:05 | Beobachtung | Upload-Fehler erstmals beobachtet. Genauer Beginn noch unbekannt. |
| 10:12 | Bearbeitung | Incident eröffnet; Incident-Leitung und Kommunikationsverantwortliche benannt. |
| 10:15 | Öffentliches Update | Untersuchung bestätigt; nächstes Update bis 10:30 zugesagt. |
| 10:30 | Öffentliches Update | Wiederherstellung noch nicht bestätigt; Untersuchung läuft weiter; nächstes Update bis 10:50. |
| 10:42 | Bearbeitung | Eine Gegenmaßnahme wird angewandt. Ihre Wirkung muss noch geprüft werden. |
| 10:50 | Öffentliches Update | Aktuelle Prüfungen zeigen eine Verbesserung; der Dienst wird beobachtet; nächstes Update bis 11:15. |
| 11:15 | Öffentliches Update | Nach den vereinbarten Wiederherstellungsprüfungen wird die Upload-Verfügbarkeit als wiederhergestellt gemeldet. Für ungelöste Kundenprobleme bleibt der Support erreichbar. |
Diese Abstände sind Beispiele, keine allgemeine Incident-Richtlinie. Wählen Sie einen Rhythmus, den das Team tatsächlich einhalten kann, und bei Bedarf kürzere Intervalle. Gibt es vor dem zugesagten Zeitpunkt eine wesentliche Änderung, kommunizieren Sie diese früher.
Ein zugesagtes Update ist keine zugesagte Fehlerbehebung. Schreiben Sie „nächstes Update bis 10:50 UTC“, nicht „ab 10:50 wieder verfügbar“ – es sei denn, Letzteres ist nachvollziehbar begründet und freigegeben. Auch wenn die Untersuchung keine neue Erkenntnis liefert, bleibt die Update-Zusage bestehen.
Statusmeldungen verwenden, die mit dem Verlauf korrekt bleiben
Die erste Bestätigung macht das Problem öffentlich bekannt. Die folgenden Meldungen zeigen, wie derselbe fiktive Vorfall weiterkommuniziert werden kann, ohne vorläufige Hinweise in Gewissheit zu verwandeln.
10:30 Uhr: Die Untersuchung läuft weiter
10:30 UTC – Untersuchung wird fortgesetzt
Wir untersuchen weiterhin Fehler beim Hochladen von Anhängen in einigen Workspaces unserer EU-Region. Es gibt noch keine bestätigte Wiederherstellungszeit und keine bestätigte Umgehungslösung. Das nächste Update veröffentlichen wir bis 10:50 UTC.
Diese Nachricht ist nützlich, obwohl sie keine Behebung ankündigt. Sie bestätigt, dass der Vorfall weiter bearbeitet wird, und lässt die vorherige Update-Zusage nicht stillschweigend verstreichen. Verzichten Sie auf Füllsätze wie „unsere Entwickler arbeiten unermüdlich“ und auf unbestätigte Ursachen.
10:50 Uhr: Die Verbesserung wird überprüft
10:50 UTC – Wiederherstellung wird beobachtet
Wir haben eine Gegenmaßnahme angewandt. Aktuelle Prüfungen zeigen, dass Anhang-Uploads in der betroffenen Region wieder erfolgreich sind. Wir beobachten die Upload-Ergebnisse, bevor wir den Dienst als wiederhergestellt melden. Erhalten Sie weiterhin einen Upload-Fehler, kontaktieren Sie bitte den Support mit Ihrer Workspace-Kennung und dem ungefähren Zeitpunkt. Bis 11:15 UTC aktualisieren wir diese Seite.
„Prüfungen zeigen eine Verbesserung“ ist enger gefasst als „alle sind wieder online“. Halten Sie diese Grenze ein. Eine wieder normale Kurve klärt für sich genommen weder die Ergebnisse früherer Versuche noch die Funktionsfähigkeit jedes einzelnen Kundenablaufs.
11:15 Uhr: Benennen, was wiederhergestellt wurde
11:15 UTC – Verfügbarkeit von Anhang-Uploads wiederhergestellt
Anhang-Uploads funktionieren in der betroffenen Region wieder normal. Während des Beobachtungszeitraums lagen die Upload-Ergebnisse im üblichen Bereich des Dienstes; die vereinbarten Upload-Prüfungen wurden bestanden. Wenn ein früherer Upload einen Fehler meldete oder sein Ergebnis unklar ist, prüfen Sie bitte Ihre Anhangsliste vor einem erneuten Versuch. Besteht weiterhin ein Problem, wenden Sie sich an den Support.
Diese Schlussmeldung setzt voraus, dass das fiktive Team die Prüfungen abgeschlossen und die Kundenanweisung für seinen Dienst bestätigt hat. Übernehmen Sie sie nicht in einen realen Vorfall, bevor diese Belege vorliegen. Sie behauptet weder eine Ursache noch eine vollständige Zahl betroffener Kunden und versichert nicht pauschal, dass keine Daten verloren gegangen sind.
Für eigene Meldungen ersetzen Sie Funktion, Umfang, beobachtetes Symptom, belegten Status, Kundenhandlung und nächsten Update-Zeitpunkt. Diese Angaben tragen die Aussage. Nur den Dienstnamen auszutauschen und unbelegte Wiederherstellungsformulierungen beizubehalten wäre keine sichere Anpassung.
Freigabe und nächstes Update im Briefing sichtbar machen
Kommunikationsverantwortliche benötigen mehr als einen fertigen Absatz. Im Briefing muss stehen, wer technische Fakten bestätigt, wer den öffentlichen Text genehmigt und wer ihn über den autorisierten Kanal veröffentlicht. Nutzen Sie Ihre tatsächlichen Incident-Rollen. Der Verfasser einer Folie darf nicht automatisch eine Wiederherstellung freigeben.
Für den fiktiven Dienst genügen fünf Briefing-Folien:
- Aktueller Status: betroffene Funktion und Region, Zeitstempel und aktuelle Incident-Verantwortung.
- Auswirkung und Unsicherheit: bestätigte und offene Punkte sowie die Quelle jeder wichtigen Aussage.
- Bearbeitung: aktuelle Maßnahmen und benötigte Entscheidungen, ohne eine ungeprüfte Hypothese als Ursache auszugeben.
- Kommunikation: freigegebener Kundentext, Supporthinweis, Veröffentlichungsverantwortung und nächster Update-Zeitpunkt.
- Wiederherstellungsnachweise: erforderliche Prüfungen für den Wechsel von Untersuchung zu Beobachtung oder wiederhergestellt, mit ihren tatsächlichen Ergebnissen, sobald verfügbar.
Trennen Sie Entwürfe sichtbar von versendeten Fassungen. Dokumentieren Sie Version, Freigabezeit, Veröffentlichungszeit und Zielkanal. Grenzt das Team den Umfang von „EU-Region“ auf bestimmte Workspaces ein, aktualisieren Sie den gemeinsamen Faktenstand und die folgenden Meldungen zusammen, statt widersprüchliche Folien im Umlauf zu lassen.
Die Google-Leitlinien zum Incident-Management betonen einen aktuellen Vorfallsstand und eine klare Übergabe. Für diese Präsentation folgt daraus etwas Einfaches: Verantwortliche Person und Zeitstempel müssen sichtbar bleiben – besonders bei einem Wechsel im Einsatzteam.
Wiederhergestellten Dienst und spätere Erklärung auseinanderhalten
Kommunizieren Sie während der Wiederherstellung, welche Funktion wieder arbeitet und was Kunden noch tun müssen. Warten Sie mit dieser Meldung nicht auf eine vollständige Ursachenanalyse. Verbergen Sie umgekehrt fortbestehende Kundenprobleme nicht hinter „behoben“, nur weil sich eine Systemkennzahl verbessert hat.
Nach dem Vorfall kann das Team beitragende Faktoren und längerfristige Änderungen in einer Incident-Postmortem-Präsentation untersuchen. Das ist ein anderes Arbeitsergebnis. Das laufende Briefing sollte keine erfundene Ursachengeschichte enthalten, nur damit die Darstellung abgeschlossen wirkt.
Wechselt die Kommunikationsverantwortung vor der Behebung, hinterlassen Sie einen nutzbaren Übergabestand. So könnte die fiktive Übergabe um 10:35 UTC zwischen Untersuchungs- und Beobachtungsupdate aussehen:
Kommunikationsübergabe – 10:35 UTC
Aktueller öffentlicher Status: Untersuchung von Anhang-Upload-Fehlern in einigen EU-gehosteten Workspaces. Letzte Meldung: Version 2, veröffentlicht um 10:30 UTC. Nächstes öffentliches Update: spätestens 10:50 UTC, auch ohne neue Erkenntnis, falls die Wiederherstellung nicht bestätigt ist. Die übernehmende Kommunikationsverantwortliche hat die Zuständigkeit akzeptiert. Die Incident-Leitung bestätigt den Betriebsstatus; die Kommunikationsverantwortliche veröffentlicht den freigegebenen Text. Wiederherstellungszeit, genauer Beginn und Zahl betroffener Workspaces bleiben unbestätigt. Das gemeinsame Vorfallsprotokoll enthält die neuesten Belege und den Supporttext.
Die übernehmende Person kann nun das nächste korrekte Update versenden, ohne den Vorfall aus dem Chatverlauf rekonstruieren oder die aktuelle Folienversion erraten zu müssen.