Une présentation de résultats expérimentaux doit permettre de répondre à trois questions : la comparaison est-elle fiable, quelle pourrait être l'ampleur de l'effet, et quelle décision en découle ? Un taux de conversion plus élevé ne répond pas à lui seul aux trois. Présentez la recommandation à côté du résultat, puis montrez le protocole et le calcul qui la justifient.
Ce guide suit un seul test A/B fictif : l'équipe d'un logiciel de réservation essaie un parcours de configuration plus court. Tous les effectifs, résultats et décisions sont construits à des fins pédagogiques. Ils ne proviennent ni d'un test de Presenti ni d'un cas client. L'amélioration observée semble intéressante, mais elle ne satisfait pas la règle de déploiement fixée par l'équipe.
Une fois l'analyse validée, vous pouvez utiliser Presenti pour transformer le texte en présentation et obtenir un brouillon de diapositives modifiable. Fournissez ensemble les chiffres approuvés et leurs limites : ce brouillon facilite la communication, mais ne remplace pas l'analyse de l'expérience.
Définir la décision et le test avant de montrer un graphique
L'équipe fictive souhaite que davantage de nouveaux utilisateurs terminent la configuration. Elle propose de supprimer deux questions facultatives du parcours initial. Son hypothèse est que cette simplification augmente la proportion d'utilisateurs admissibles qui terminent en sept jours. La décision porte sur le remplacement du parcours actuel pour tous les nouveaux utilisateurs admissibles, pas sur la préférence esthétique pour une version.
| Élément | Définition retenue dans l'exemple |
|---|---|
| Population | Nouveaux utilisateurs admissibles au parcours ; comptes de test internes exclus avant l'affectation |
| Unité de randomisation | Un utilisateur identifié de façon stable entre les visites ; les visites suivantes conservent l'affectation initiale |
| Comparaison | Parcours actuel contre parcours raccourci, testés simultanément avec une répartition prévue de 1:1 |
| Critère principal | Au moins une finalisation enregistrée dans les sept jours suivant l'affectation, comptée une fois par utilisateur |
| Période d'observation | Recrutement des jours 1 à 14 ; restitution finale après sept jours complets de suivi pour le dernier utilisateur recruté |
| Indicateur de vigilance pour le support | Au moins un contact avec le support lié à la configuration pendant la même période de sept jours, compté une fois par utilisateur |
L'affectation aléatoire compte parce que les utilisateurs ne choisissent pas la version reçue. Le NIST décrit, dans son explication du plan complètement randomisé, l'attribution aléatoire des traitements aux unités expérimentales. Une comparaison avant-après, ou entre des personnes ayant choisi d'essayer un nouveau parcours, demanderait une autre analyse des biais et ne permettrait pas les mêmes conclusions causales.
Dans cet exemple, l'équipe a convenu d'une règle de déploiement simplifiée avant de consulter les résultats : l'amélioration estimée du taux de finalisation doit atteindre au moins 2 points de pourcentage, son intervalle de confiance bilatéral à 95 % doit rester entièrement au-dessus de zéro, et la borne supérieure de l'augmentation des contacts avec le support doit rester sous 1 point. Ces seuils illustrent une politique de décision ; ce ne sont pas des normes universelles pour les tests A/B. Un véritable protocole doit aussi prévoir un calcul d'effectif adapté et une méthode d'analyse définie avant l'examen des résultats.
Garder tous les utilisateurs affectés dans le dénominateur
Montrez les effectifs avant les pourcentages. Dans les données fictives, chaque groupe comprend 2 000 utilisateurs affectés. Celui qui abandonne la configuration reste dans le dénominateur. Diviser seulement par le nombre de personnes ayant atteint la dernière étape exclurait précisément le comportement que le parcours raccourci cherche à modifier.
| Mesure | Parcours actuel | Parcours raccourci |
|---|---|---|
| Utilisateurs admissibles affectés | 2 000 | 2 000 |
| Utilisateurs ayant terminé la configuration | 800 | 860 |
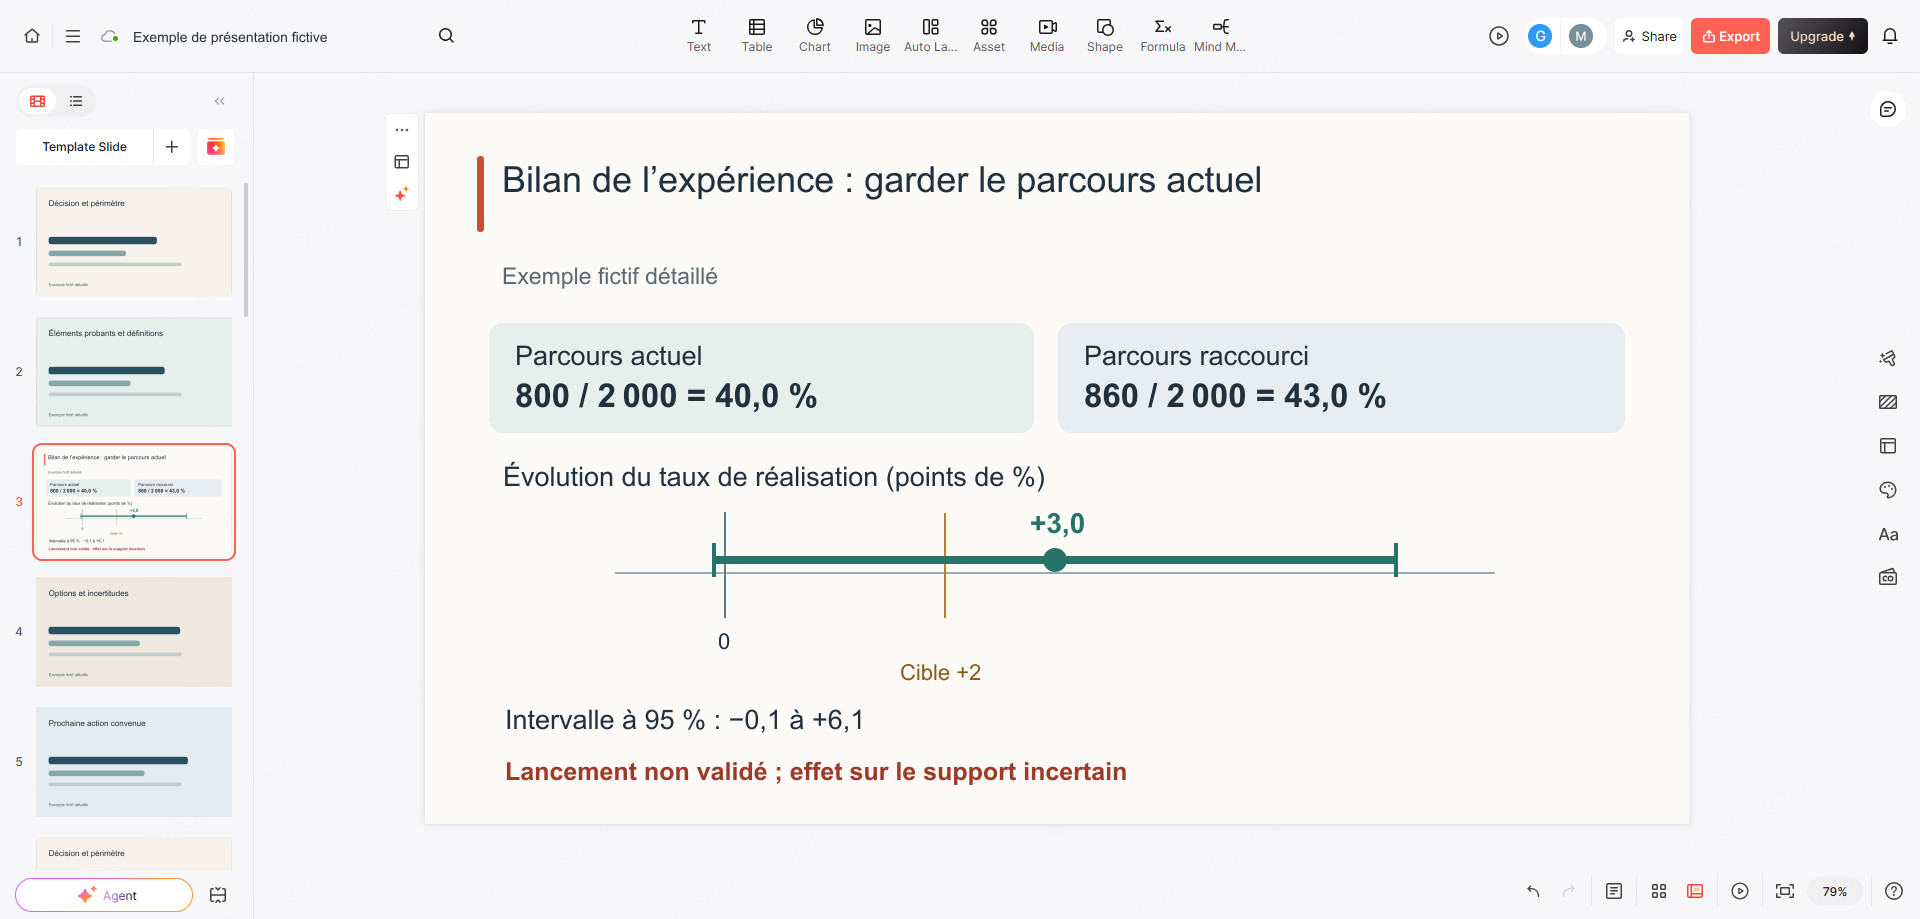
| Taux de finalisation | 800 / 2 000 = 40,0 % | 860 / 2 000 = 43,0 % |
| Utilisateurs ayant contacté le support pour la configuration | 40 | 44 |
| Taux de contact avec le support | 40 / 2 000 = 2,0 % | 44 / 2 000 = 2,2 % |
L'exemple suppose une collecte fiable des événements, aucune donnée de résultat manquante et des observations indépendantes. Dans une analyse réelle, l'absence d'événement de finalisation ne peut être interprétée comme une absence de finalisation que si la mesure fonctionnait. Une panne, un appareil non suivi ou un rapprochement d'identifiants défectueux n'est pas automatiquement un zéro. Si la collecte diffère entre les variantes, il faut résoudre ce problème avant d'interpréter l'écart de taux.
Présentez aussi les contrôles d'affectation et d'exclusion. Les travaux de Microsoft sur le sample ratio mismatch, c'est-à-dire un écart inattendu dans les proportions affectées aux variantes, expliquent pourquoi ce signal peut révéler un problème de données. L'égalité des effectifs facilite ici l'exemple ; elle ne prouve pas que l'affectation, la journalisation ou les règles d'admissibilité étaient correctes. Ne retirez pas non plus après l'affectation les utilisateurs qui n'ont pas interagi.
Présenter l'écart absolu avec son incertitude
Le résultat peut s'exprimer de deux façons mathématiquement exactes : 43,0 % moins 40,0 % donnent une hausse de 3,0 points de pourcentage, tandis que 3,0 divisés par 40,0 donnent une hausse relative de 7,5 %. Commencez par les points de pourcentage et montrez les taux d'origine. Un titre limité à « +7,5 % » cache la base de comparaison et peut être pris pour un gain de 7,5 points.
Pour le calcul pédagogique, utilisons l'intervalle par approximation normale pour deux proportions indépendantes décrit dans le cours de Penn State sur la comparaison de paramètres de population. L'erreur-type estimée est la racine carrée de [0,43 × 0,57 / 2 000 + 0,40 × 0,60 / 2 000], soit environ 0,01557. La différence de 0,03, plus ou moins 1,96 fois cette erreur-type, donne un intervalle approximatif à 95 % de −0,1 à +6,1 points de pourcentage après arrondi.
Ce calcul convient à cet exemple volontairement simple : résultats binaires indépendants, avec suffisamment de réussites et d'échecs dans les deux groupes. Il ne se transpose pas automatiquement à des sessions répétées, à des comptes randomisés en grappes, à des événements rares ou à un protocole séquentiel. Utilisez l'intervalle issu de la méthode approuvée pour votre expérience réelle.
| Résultat | Variation estimée | Intervalle approximatif à 95 % | Conséquence pour la décision |
|---|---|---|---|
| Finalisation de la configuration | +3,0 points de pourcentage | −0,1 à +6,1 points | L'estimation dépasse +2 points, mais l'intervalle comprend zéro ; la règle de déploiement n'est pas satisfaite |
| Contact avec le support | +0,2 point de pourcentage | −0,7 à +1,1 point | La borne supérieure dépasse la hausse autorisée de +1 point ; le critère de vigilance n'est pas satisfait |
Sur le graphique principal, représentez l'écart de finalisation par un point à +3,0, un intervalle de −0,1 à +6,1, une ligne de référence à zéro et un repère distinct pour la cible pratique de +2 points. Nommez l'axe « Variation du taux de finalisation, en points de pourcentage ». Ne représentez pas 43 % comme l'effet et n'exagérez pas une petite différence avec deux barres dont l'axe est tronqué.
Un intervalle qui comprend zéro ne prouve pas l'absence d'effet. Ici, une amélioration faible ou nulle comme une amélioration utile restent compatibles avec le calcul. Inversement, une estimation ponctuelle positive ne démontre pas un effet positif. Le résultat du support ne permet pas non plus d'affirmer « aucune charge supplémentaire » : son incertitude dépasse la tolérance définie par l'équipe.
Traiter le désaccord plutôt que le reléguer en annexe
Imaginons trois réactions. Le marketing veut annoncer « un onboarding 7,5 % plus efficace ». Un analyste conclut que l'expérience ne montre aucun effet. La cheffe de produit propose de poursuivre le test jusqu'à obtenir un résultat significatif. La restitution doit distinguer la préoccupation légitime derrière chaque réaction de la conclusion réellement soutenue par les données.
| Position | Point à reconnaître | Message de la diapositive de décision |
|---|---|---|
| « Le gain relatif justifie le déploiement. » | La direction et l'ampleur observées sont encourageantes | Le taux observé passe de 40 à 43 % ; l'incertitude et le critère du support empêchent le déploiement général selon ce protocole |
| « Le changement ne sert à rien. » | Le seuil de preuve n'a pas été atteint | Le résultat ne tranche pas la décision de déploiement ; il ne prouve pas l'équivalence des variantes |
| « Continuons jusqu'à ce que le test passe. » | Des informations supplémentaires pourraient être utiles | Clore cette analyse à horizon fixe comme prévu ; demander à l'analyste un protocole de suivi justifié plutôt qu'improviser une règle d'arrêt |
Un suivi continu est possible avec une méthode adaptée, mais il ne revient pas à appliquer sans cesse une règle de décision ordinaire prévue pour un horizon fixe. Les travaux de Microsoft Research sur les règles d'arrêt appropriées expliquent pourquoi méthode d'analyse et politique d'arrêt doivent être conçues ensemble.
La même prudence s'applique aux sous-groupes. Si les utilisateurs mobiles semblent davantage bénéficier du changement, précisez si cette comparaison était prévue et combien de découpages ont été examinés. Un résultat exploratoire peut motiver une hypothèse pour la suite. Il ne doit pas remplacer discrètement le critère principal parce qu'il permet un titre plus favorable.
Construire six diapositives à partir de l'analyse validée
Utilisez la structure suivante comme modèle de travail. Chaque diapositive remplit une fonction distincte. La première donne la recommandation ; les suivantes permettent de la discuter sans fouiller dans un tableur pendant la réunion.
| Diapositive | Exemple de titre | Contenu à présenter |
|---|---|---|
| 1. Décision | Ne pas remplacer le parcours actuel pour le moment | Gain observé de +3,0 points ; critères de déploiement et de support non satisfaits ; décision demandée au responsable produit |
| 2. Protocole | Un utilisateur, une affectation, sept jours de suivi | Admissibilité, contrôle simultané, allocation, définition du résultat, périodes de recrutement et de suivi |
| 3. Validité des données | Le dénominateur comprend tous les utilisateurs admissibles affectés | 2 000 par groupe, exclusions, contrôles de collecte et d'affectation, éventuels problèmes de mesure non résolus |
| 4. Résultat principal | Le gain observé est prometteur, mais incertain | 800/2 000 contre 860/2 000 ; effet absolu, intervalle, référence à zéro et cible pratique |
| 5. Support et limites | L'effet sur le support reste incertain | 40 contre 44 utilisateurs ayant contacté le support, intervalle, tolérance et limites de la population étudiée |
| 6. Action consignée | Conserver le parcours actuel et définir le prochain test | Le responsable produit accepte la décision ; l'analyste propose le protocole de suivi ; le responsable du support examine les questions retirées avant un nouveau test |
Joignez l'analyse sous-jacente, les définitions des indicateurs et les diagnostics d'affectation comme pièces d'appui. Une diapositive n'a pas à montrer chaque ligne, mais chacun doit pouvoir relier un chiffre clé à la version validée de l'analyse. Pour préparer le brouillon avec une IA, fournissez la mention « exemple fictif », les deux dénominateurs, les deux intervalles et la règle de déploiement. Relisez les diapositives pour détecter une négation supprimée, une unité modifiée ou un verdict inventé.
Consigner l'action que ce résultat justifie réellement
Pour ce test fictif, la décision consignée est la suivante : conserver le parcours actuel ; ne revendiquer ni amélioration prouvée de la finalisation ni validation du critère de support ; demander à l'analyste et au responsable du support de proposer la prochaine étude avant toute nouvelle décision de lancement. Celle-ci pourrait tester des indications révisées ou chercher à mesurer un effet plus petit. Sa question, son effectif, ses mesures et sa règle d'arrêt doivent toutefois être fixés avant l'examen de nouveaux résultats.
La restitution a rempli son rôle lorsque l'équipe peut expliquer pourquoi elle choisit cette action. Une présentation convaincante ne transforme pas un résultat incertain en certitude. Elle rend visibles, sur une même page, les éléments de preuve, le seuil métier et le choix qui reste à faire.