実験結果の報告では、「比較は信頼できるか」「効果はどの程度と考えられるか」「その結果から何を決めるか」の3つに答えられるようにします。コンバージョン率が高かったというだけでは、すべてには答えられません。結果の隣に提案する判断を置き、その根拠となる設計と計算を示しましょう。
この記事では、予約ソフトウェアのチームが初期設定を短縮する架空のA/Bテストを一貫して使います。以下の件数、結果、判断はすべて学習用に作ったもので、Presentiの実験や顧客実績ではありません。観測された改善は魅力的ですが、チームが事前に定めた導入条件は満たしていません。
分析の承認後は、Presentiのテキストからプレゼン資料を作る機能で報告の構成を編集可能なスライドにできます。承認済みの数値と、その解釈上の条件を一緒に入力してください。スライドは分析を伝えるためのものであり、実験分析の代わりではありません。
グラフの前に、判断事項と実験内容を示す
架空のチームは、初期設定を完了する新規ユーザーを増やしたいと考えています。変更内容は、オンボーディングから任意の質問を2つ削除することです。手間が減り、対象となる新規ユーザーが7日以内に設定を完了する割合が増える、という仮説です。判断するのは、すべての対象ユーザーの設定フローを置き換えるかどうかであって、短い画面のほうが見た目に好ましいかではありません。
| 項目 | この例での定義 |
|---|---|
| 対象集団 | 初期設定フローの利用条件を満たす新規ユーザー。社内テストアカウントは割り当て前に除外する。 |
| ランダム化の単位 | 訪問をまたいで一貫して識別できる1人のユーザー。再訪しても元の割り当てを維持する。 |
| 比較 | 既存フローと短縮フローを同時期に実行し、予定割り当て比率を1:1とする。 |
| 主要評価項目 | 割り当てから7日以内に少なくとも1回の設定完了が記録されたか。ユーザーごとに1回だけ数える。 |
| 観測期間 | 1~14日目に対象者を組み入れ、最後に組み入れたユーザーの7日間の追跡が完了してから最終報告する。 |
| サポートのガードレール指標 | 同じ7日間に、設定に関する問い合わせが少なくとも1回あったか。ユーザーごとに1回だけ数える。 |
ランダム割り当てでは、ユーザー自身が使うバージョンを選ばないことが重要です。NISTの完全無作為化計画の解説も、実験単位に処置をランダムに割り当てる設計を説明しています。導入前後の比較や、新しいフローを自ら選んだ人との比較では、別のバイアスを説明する必要があり、同じ因果的な表現は使えません。
この例では、結果を見る前に簡略化した導入条件を合意しています。完了率の改善推定値が2パーセントポイント以上で、両側95%信頼区間の全体がゼロを上回り、サポート問い合わせ率の増加については区間の上限が1パーセントポイント未満であることです。これは判断方針の例であり、A/Bテスト共通の基準ではありません。実際の計画では、適切なサンプルサイズの算定と、結果を確認する前に合意した分析方法も必要です。
割り当てたユーザーを分母に残す
割合より先に件数を示します。架空のデータでは、各群に2,000人が割り当てられています。途中で設定をやめたユーザーも分母に残します。最後の設定画面まで到達した人だけを分母にすると、短縮フローによって変えたい行動そのものを集計から除いてしまいます。
| 指標 | 既存フロー | 短縮フロー |
|---|---|---|
| 割り当てられた対象ユーザー | 2,000 | 2,000 |
| 設定を完了したユーザー | 800 | 860 |
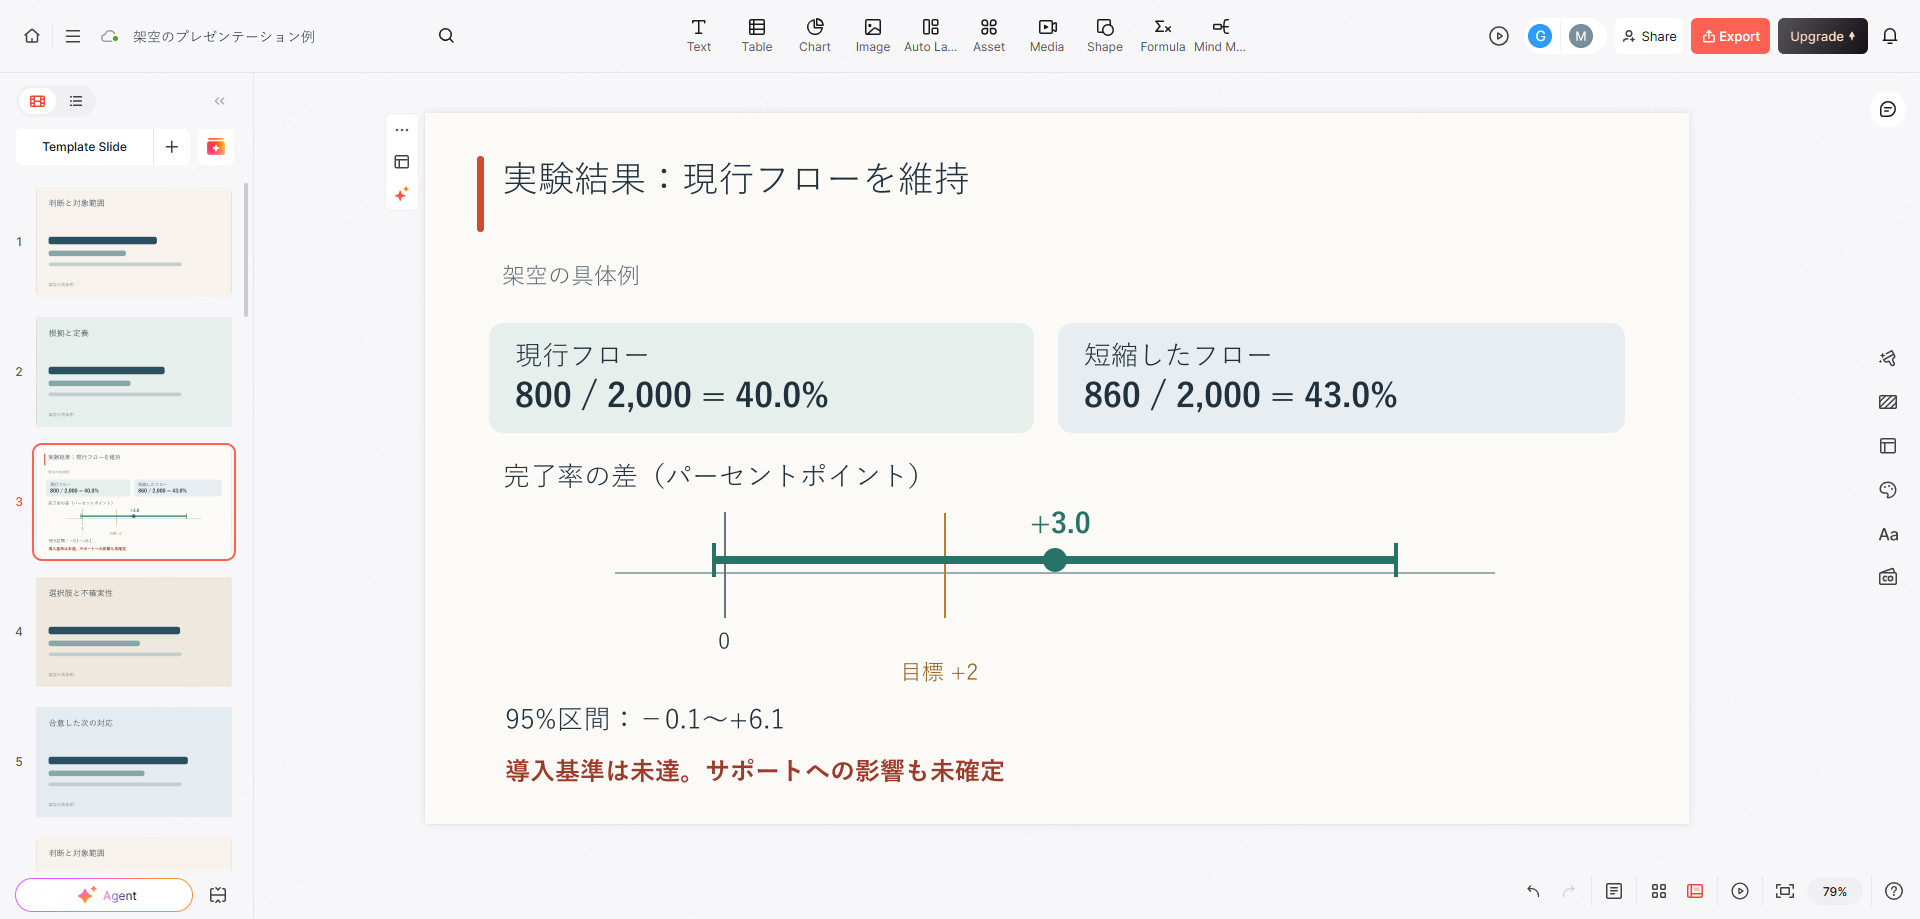
| 完了率 | 800 / 2,000 = 40.0% | 860 / 2,000 = 43.0% |
| 設定に関してサポートへ問い合わせたユーザー | 40 | 44 |
| サポート問い合わせ率 | 40 / 2,000 = 2.0% | 44 / 2,000 = 2.2% |
この例では、イベントを正しく取得でき、結果の欠測がなく、観測が独立していると仮定しています。実際には、完了イベントがないことを未完了と扱えるのは、測定システムが正常に動いていた場合だけです。障害、計測対象外の端末、ユーザー識別の紐づけ不良は、自動的にゼロを意味しません。バージョンごとに結果の取得状況が違うなら、率の差を解釈する前に解消します。
この表とともに、割り当てと除外条件の検証結果も報告します。Microsoftのサンプル比率の不一致に関する研究は、想定外の割り当て比率が実験データの問題を示す場合があると説明しています。今回は分かりやすさのため両群を同数にしていますが、人数が同じでも、割り当て、ログ、対象条件が正しかった証明にはなりません。また、割り当て後に利用しなかったという理由だけでユーザーを除外してはいけません。
絶対差と不確実性を示す
完了率の変化は、数学的には2通りの正しい表現ができます。43.0%から40.0%を引くと3.0パーセントポイントの増加です。また、3.0を40.0で割ると相対的に7.5%の増加です。まずパーセントポイントで差を示し、元の率も併記します。「7.5%改善」とだけ書くと出発点が見えず、7.5ポイントの増加と誤解されやすくなります。
説明用の計算には、Penn Stateの母集団パラメータ比較の講義で扱う、独立した2つの比率の正規近似区間を使います。推定標準誤差は [0.43 × 0.57 / 2,000 + 0.40 × 0.60 / 2,000] の平方根で、約0.01557です。差の0.03に、標準誤差の1.96倍を加減すると、概算の95%信頼区間は、丸めた後で−0.1~+6.1パーセントポイントになります。
この計算は、結果が独立した二値で、両群に成功と失敗が十分あるという、意図的に単純化した例に対応しています。繰り返しのセッション、アカウント単位のクラスターランダム化、まれなイベント、逐次デザインにそのまま使う公式ではありません。実際の実験では、承認済みの分析から得られた区間を使ってください。
| 評価項目 | 推定した変化 | 概算の95%信頼区間 | 判断への意味 |
|---|---|---|---|
| 設定の完了 | +3.0パーセントポイント | −0.1~+6.1ポイント | 点推定値は+2ポイントを超えるが、区間にはゼロが含まれるため、導入条件を満たさない。 |
| サポートへの問い合わせ | +0.2パーセントポイント | −0.7~+1.1ポイント | 上限が許容する+1ポイントを超えているため、ガードレールの条件を満たしたとはいえない。 |
主なグラフでは、完了率の差を+3.0の点で示し、−0.1~+6.1の区間、ゼロの基準線、実務上の目標である+2ポイントの線を別々に描きます。軸名は「完了率の変化(パーセントポイント)」とします。43%を効果そのものとして描いたり、2本の棒の軸を切って小さな差を極端に大きく見せたりしないでください。
区間がゼロをまたいでも、効果がないと証明したことにはなりません。この計算では、改善がほとんどない場合と、意味のある改善がある場合のどちらも残っています。逆に、点推定値が正でも、正の効果が確定したわけではありません。サポートについても、不確実性が許容範囲を超えているため、「負担は増えない」とは結論できません。
意見の違いを付録に隠さず、その場で整理する
結果を見た3人の反応を考えてみます。マーケティング担当は「オンボーディングが7.5%改善」と告知したいと考え、分析担当は効果が見つからなかったと言い、プロダクトマネージャーは有意になるまで実験を続けようと提案します。報告資料では、それぞれの妥当な関心と、データから言える結論を分けます。
| 意見 | 認められる点 | 判断スライドに書く内容 |
|---|---|---|
| 「相対改善は大きいので導入すべき」 | 観測した方向と大きさには期待が持てる。 | 観測完了率は40%から43%に上昇したが、不確実性とサポートの条件により、今回の計画では全面導入できない。 |
| 「変更しても意味がない」 | 必要な証拠の水準には達していない。 | 導入判断には結論が出ない結果であって、両者が同等という証明ではない。 |
| 「条件を満たすまでデータを集めよう」 | 追加の情報が有用な可能性はある。 | 固定期間の分析は予定どおり閉じ、思いつきの停止ルールではなく、根拠ある追加実験の設計を分析担当に求める。 |
適切な方法を用いれば継続監視はできますが、通常の固定期間の判断ルールを何度も当てはめることとは異なります。Microsoft Researchの適切な停止ルールに関する研究は、分析方法と停止方針を一緒に設計する必要性を説明しています。
サブグループの分析にも同じ慎重さが必要です。モバイルユーザーで効果が大きく見えるなら、その比較を事前に予定していたか、何通りの切り口を調べたかを示します。探索的な分析は次の仮説につながりますが、見栄えのよい結果が出たからといって、黙って主要評価項目に置き換えてはいけません。
承認済みの分析を6枚の報告資料にする
次の構成を作業用のひな形として使えます。各スライドの役割は異なります。最初に提案する判断を示し、後のスライドで、会議中に表計算ファイルを探し回らずにその判断を検討できるようにします。
| スライド | 見出しの例 | 載せる内容 |
|---|---|---|
| 1. 判断 | 現時点では既存の設定フローを置き換えない | 観測改善は+3.0ポイント。導入条件とサポート条件は未達。プロダクト責任者に求める判断。 |
| 2. 実験設計 | 1ユーザーに1つの割り当て、追跡は7日間 | 対象条件、同時期の対照群、割り当て、評価項目の定義、組み入れ期間と追跡期間。 |
| 3. データの妥当性 | 分母は割り当てたすべての対象ユーザー | 各群2,000人、除外、ログの検証、割り当ての診断、未解決の測定問題。 |
| 4. 主要結果 | 観測改善には期待があるが、不確実性が残る | 800/2,000と860/2,000、絶対差、区間、ゼロの線、実務上の目標。 |
| 5. ガードレールと限界 | サポートへの影響はまだ確定できない | 問い合わせたユーザー40人と44人、区間、許容範囲、実験対象集団の限界。 |
| 6. 決定した対応 | 現行フローを維持し、次の実験を定義する | プロダクト責任者が判断を受け入れる。分析担当が追加実験を設計し、サポート責任者が削除した質問を次の実験前に検討する。 |
元の分析、指標の定義、割り当ての診断結果を裏付け資料として添えます。スライドに全行を表示する必要はありませんが、見出しの数値を承認済みの分析バージョンまでたどれるようにします。AIで下書きを作るときは、「架空の計算例」であること、両群の分母、2つの区間、導入条件を入力に含めます。生成された文章で、否定が抜けていないか、単位が変わっていないか、存在しない結論が追加されていないかを確認してください。
この結果が支持する、具体的な次の行動を記録する
架空の実験の決定記録は、現行の設定フローを維持する。完了率の改善が証明されたとも、サポートのガードレールを満たしたとも主張しない。次の導入判断の前に、分析担当とサポート責任者へ追加調査の提案を求める、となります。追加実験では案内文の修正を試したり、より小さな効果を判断できる設計にしたりできますが、問い、サンプルサイズ、測定、停止ルールは新しい結果を見る前に定める必要があります。
チームがその行動を選ぶ理由を説明できれば、報告の役割は果たせています。説得力のある実験資料とは、不確かな結果を確かなものに見せる資料ではありません。証拠、事業上の基準、まだ決めきれない点を、同じページに示す資料です。