Nach einer Ergebnispräsentation sollten alle im Raum drei Fragen beantworten können: War der Vergleich belastbar? Wie groß könnte der Effekt tatsächlich sein? Und welche Entscheidung folgt daraus? Eine höhere Abschlussquote allein beantwortet nicht alle drei. Stellen Sie die Empfehlung neben das Ergebnis und zeigen Sie anschließend, welches Versuchsdesign und welche Berechnung sie tragen.
Dieser Leitfaden arbeitet durchgehend mit einem fiktiven A/B-Test: Das Team einer Buchungssoftware erprobt einen kürzeren Einrichtungsprozess. Sämtliche Fallzahlen, Ergebnisse und Entscheidungen dienen der Veranschaulichung. Sie stammen weder aus einem Presenti-Test noch aus einem Kundenprojekt. Die beobachtete Verbesserung sieht vielversprechend aus, erfüllt aber nicht die vorab festgelegte Einführungsregel.
Ist die Analyse freigegeben, können Sie mit Presenti aus dem Text einen Präsentationsentwurf erstellen. Übergeben Sie die geprüften Zahlen zusammen mit ihren Einschränkungen. Der bearbeitbare Folienentwurf unterstützt die Kommunikation; er ersetzt nicht die statistische Auswertung.
Entscheidung und Versuchsdesign vor der ersten Grafik erklären
Das fiktive Team möchte erreichen, dass mehr neue Nutzer die Einrichtung abschließen. Dafür entfernt es zwei optionale Fragen aus dem Einrichtungsprozess. Die Hypothese: Weniger Aufwand erhöht den Anteil der berechtigten neuen Nutzer, die innerhalb von sieben Tagen fertig werden. Entschieden werden soll, ob der bisherige Prozess für alle berechtigten neuen Nutzer ersetzt wird – nicht, welche Variante besser aussieht.
| Merkmal | Festlegung im Beispiel |
|---|---|
| Grundgesamtheit | Neue Nutzer, für die der Einrichtungsprozess vorgesehen ist; interne Testkonten werden vor der Zuteilung ausgeschlossen |
| Randomisierungseinheit | Ein über mehrere Besuche hinweg eindeutig identifizierter Nutzer; spätere Besuche behalten die ursprüngliche Zuordnung |
| Vergleich | Bisheriger und verkürzter Prozess laufen gleichzeitig; geplante Zuteilung 1:1 |
| Primäre Zielgröße | Mindestens ein erfasster Einrichtungsabschluss innerhalb von sieben Tagen nach Zuteilung, einmal je Nutzer gezählt |
| Beobachtungszeitraum | Aufnahme an den Tagen 1–14; abschließende Auswertung erst, wenn auch der zuletzt aufgenommene Nutzer sieben volle Tage beobachtet wurde |
| Schutzkennzahl für den Support | Mindestens ein einrichtungsbezogener Supportkontakt im selben Siebentagefenster, einmal je Nutzer gezählt |
Die zufällige Zuteilung ist wichtig: Die Nutzer wählen ihre Variante nicht selbst. NIST erläutert beim vollständig randomisierten Versuchsplan, wie Behandlungen den Versuchseinheiten zufällig zugewiesen werden. Bei einem Vorher-nachher-Vergleich oder bei Nutzern, die sich freiwillig für den neuen Prozess entscheiden, müssten mögliche Verzerrungen anders behandelt werden. Solche Vergleiche erlauben nicht dieselben Aussagen über Ursache und Wirkung.
Für das Beispiel vereinbart das Team vor Einsicht in die Ergebnisse eine vereinfachte Einführungsregel: Der geschätzte Anstieg der Abschlussquote muss mindestens 2 Prozentpunkte betragen, das zweiseitige 95-%-Konfidenzintervall muss vollständig oberhalb von null liegen, und die obere Intervallgrenze für zusätzliche Supportkontakte muss unter 1 Prozentpunkt bleiben. Diese Schwellen illustrieren eine Entscheidungsregel; sie sind kein allgemeiner Standard für A/B-Tests. Ein realer Versuchsplan benötigt außerdem eine passende Fallzahlplanung und ein vorab vereinbartes Auswertungsverfahren.
Alle zugeteilten Nutzer im Nenner behalten
Zeigen Sie zuerst die Fallzahlen, dann die Prozentsätze. Im fiktiven Datensatz wurden jeder Gruppe 2.000 Nutzer zugeteilt. Wer die Einrichtung abbricht, bleibt im Nenner. Würden Sie nur durch die Zahl der Nutzer teilen, die den letzten Einrichtungsschritt erreicht haben, blendeten Sie genau das Verhalten aus, das der kürzere Prozess verändern soll.
| Kennzahl | Bisheriger Prozess | Verkürzter Prozess |
|---|---|---|
| Zugeteilte berechtigte Nutzer | 2.000 | 2.000 |
| Nutzer mit abgeschlossener Einrichtung | 800 | 860 |
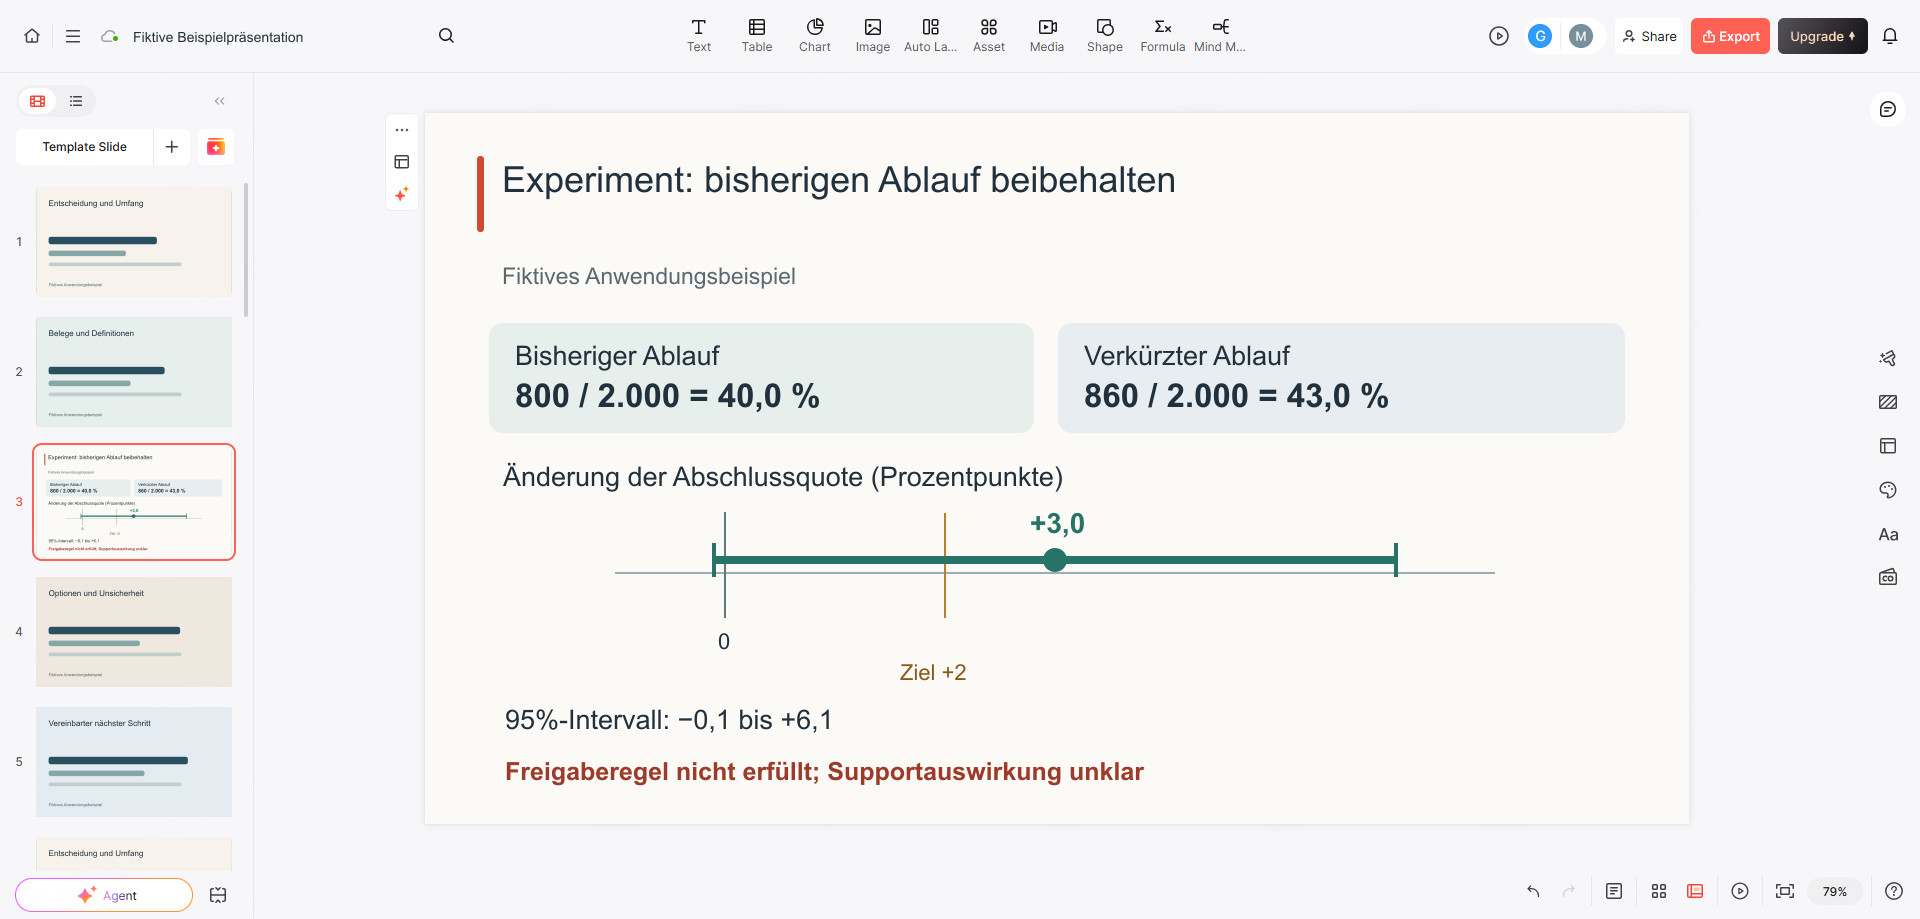
| Abschlussquote | 800 / 2.000 = 40,0 % | 860 / 2.000 = 43,0 % |
| Nutzer mit einrichtungsbezogenem Supportkontakt | 40 | 44 |
| Supportkontaktquote | 40 / 2.000 = 2,0 % | 44 / 2.000 = 2,2 % |
Das Beispiel setzt eine zuverlässige Ereigniserfassung, vollständige Ergebnisdaten und unabhängige Beobachtungen voraus. In einer realen Auswertung darf ein fehlendes Abschlussereignis nur dann als Nichtabschluss gelten, wenn die Messung funktioniert hat. Ein Ausfall, ein nicht erfasstes Gerät oder eine fehlerhafte Zuordnung von Nutzerkennungen ist nicht automatisch eine Null. Unterscheidet sich die Erfassung zwischen den Varianten, muss dieses Problem geklärt werden, bevor Sie den Quotenunterschied interpretieren.
Dokumentieren Sie neben der Tabelle auch die Prüfungen von Zuteilung und Ausschlüssen. Die Microsoft-Forschung zu Sample Ratio Mismatch erklärt, warum eine unerwartete Verteilung auf die Varianten auf Datenprobleme hinweisen kann. Die gleichen Gruppengrößen vereinfachen hier das Beispiel. Sie beweisen nicht, dass Zuteilung, Protokollierung oder Teilnahmeregeln korrekt waren. Entfernen Sie nach der Zuteilung auch nicht einfach Nutzer, die nicht aktiv wurden.
Absoluten Unterschied und Unsicherheit gemeinsam zeigen
Das Ergebnis lässt sich auf zwei mathematisch korrekte Arten ausdrücken: 43,0 % minus 40,0 % ergeben einen Anstieg um 3,0 Prozentpunkte. 3,0 geteilt durch 40,0 ergibt einen relativen Anstieg um 7,5 %. Nennen Sie zuerst die Prozentpunkte und zeigen Sie die Ausgangsquoten. Die alleinige Überschrift „7,5 % besser“ verschweigt die Bezugsgröße und kann leicht mit einem Anstieg um 7,5 Prozentpunkte verwechselt werden.
Für die Beispielrechnung verwenden wir das normalapproximative Intervall für zwei unabhängige Anteilswerte aus der Penn-State-Lektion zum Vergleich von Populationsparametern. Der geschätzte Standardfehler ist die Quadratwurzel aus [0,43 × 0,57 / 2.000 + 0,40 × 0,60 / 2.000], also ungefähr 0,01557. Die Differenz 0,03 plus/minus 1,96-mal dieser Standardfehler ergibt nach Rundung ein angenähertes 95-%-Intervall von −0,1 bis +6,1 Prozentpunkten.
Diese Rechnung passt zum bewusst einfachen Beispiel: unabhängige binäre Ergebnisse mit ausreichend vielen Erfolgen und Misserfolgen in beiden Gruppen. Die Formel lässt sich nicht ungeprüft auf wiederholte Sitzungen, auf Kontoebene randomisierte Cluster, seltene Ereignisse oder ein sequenzielles Design übertragen. Verwenden Sie für Ihren tatsächlichen Versuch das Intervall aus dem freigegebenen Auswertungsverfahren.
| Zielgröße | Geschätzte Änderung | Angenähertes 95-%-Intervall | Bedeutung für die Entscheidung |
|---|---|---|---|
| Einrichtungsabschluss | +3,0 Prozentpunkte | −0,1 bis +6,1 Punkte | Der Punktschätzer liegt über +2 Punkten, das Intervall umfasst aber null; die Einführungsregel ist nicht erfüllt |
| Supportkontakt | +0,2 Prozentpunkte | −0,7 bis +1,1 Punkte | Die obere Grenze überschreitet den zulässigen Anstieg von +1 Prozentpunkt; die Schutzkennzahl erfüllt ihre Freigaberegel nicht |
Zeigen Sie in der Hauptgrafik die Abschlussdifferenz als Punkt bei +3,0, das Intervall von −0,1 bis +6,1, eine Nulllinie und eine separate Markierung des praktischen Ziels bei +2,0. Beschriften Sie die Achse mit „Änderung der Abschlussquote in Prozentpunkten“. Stellen Sie nicht 43 % als Effekt dar und vergrößern Sie den Unterschied nicht künstlich durch zwei Balken mit abgeschnittener Achse.
Ein Intervall, das null umfasst, beweist nicht, dass kein Effekt existiert. In diesem Beispiel sind sowohl eine geringe oder ausbleibende Verbesserung als auch eine lohnende Verbesserung mit der Berechnung vereinbar. Umgekehrt belegt ein positiver Punktschätzer noch keinen positiven Effekt. Auch die Supportdaten rechtfertigen nicht die Aussage „keine zusätzliche Belastung“: Ihre Unsicherheit reicht über die vereinbarte Toleranz hinaus.
Meinungsverschiedenheiten offen klären statt im Anhang verstecken
Stellen Sie sich drei Reaktionen vor: Das Marketing möchte „7,5 % besseres Onboarding“ verkünden. Ein Analyst erklärt, der Versuch habe keinen Effekt gezeigt. Die Produktmanagerin schlägt vor, den Test weiterlaufen zu lassen, bis er signifikant wird. Die Präsentation sollte das berechtigte Anliegen hinter jeder Reaktion von der Schlussfolgerung trennen, die die Daten tatsächlich stützen.
| Position | Berechtigtes Anliegen | Aussage auf der Entscheidungsfolie |
|---|---|---|
| „Der relative Gewinn rechtfertigt die Einführung.“ | Richtung und beobachtete Größenordnung sind ermutigend | Die beobachtete Abschlussquote stieg von 40 auf 43 %; Unsicherheit und Supportregel verhindern nach diesem Plan eine breite Einführung |
| „Die Änderung bringt nichts.“ | Die erforderliche Evidenzschwelle wurde nicht erreicht | Das Ergebnis erlaubt keine eindeutige Einführungsentscheidung; es beweist nicht die Gleichwertigkeit beider Varianten |
| „Wir sammeln weiter, bis es reicht.“ | Zusätzliche Informationen könnten nützlich sein | Diese Auswertung zum festen Endzeitpunkt wird wie geplant abgeschlossen; der Analyst plant eine begründete Folgestudie statt einer spontanen Abbruchregel |
Kontinuierliche Beobachtung ist mit einem geeigneten Verfahren möglich. Sie ist aber nicht dasselbe wie die wiederholte Anwendung einer gewöhnlichen Entscheidungsregel für einen festen Auswertungszeitpunkt. Die Microsoft-Forschung zu geeigneten Stoppregeln erläutert, warum Auswertungsmethode und Stoppregel zusammen geplant werden müssen.
Dieselbe Zurückhaltung gilt für Untergruppen. Scheinen mobile Nutzer stärker zu profitieren, sollten Sie angeben, ob dieser Vergleich geplant war und wie viele Aufteilungen untersucht wurden. Eine explorative Auswertung kann eine neue Hypothese begründen. Sie darf aber nicht unbemerkt die primäre Zielgröße ersetzen, nur weil ihre Überschrift günstiger ausfällt.
Aus der freigegebenen Analyse sechs Folien aufbauen
Die folgende Struktur dient als Arbeitsvorlage. Jede Folie hat eine eigene Aufgabe. Die erste nennt die Empfehlung; die weiteren ermöglichen es, diese Empfehlung zu hinterfragen, ohne während der Besprechung in einer Tabelle suchen zu müssen.
| Folie | Beispieltitel | Inhalt |
|---|---|---|
| 1. Entscheidung | Den bisherigen Einrichtungsprozess noch nicht ersetzen | Beobachteter Anstieg um +3,0 Punkte; Einführungs- und Supportkriterien nicht erfüllt; Entscheidung durch die Produktverantwortlichen erforderlich |
| 2. Versuchsdesign | Ein Nutzer, eine Zuteilung, sieben Tage Beobachtung | Teilnahmebedingungen, gleichzeitige Kontrollgruppe, Zuteilung, Zieldefinition sowie Aufnahme- und Beobachtungszeitraum |
| 3. Datengrundlage | Der Nenner umfasst alle zugeteilten berechtigten Nutzer | 2.000 je Gruppe, Ausschlüsse, Erfassungsprüfungen, Zuteilungsdiagnostik und offene Messprobleme |
| 4. Hauptergebnis | Der beobachtete Gewinn ist vielversprechend, aber unsicher | 800/2.000 gegenüber 860/2.000; absoluter Effekt, Intervall, Nulllinie und praktisches Ziel |
| 5. Schutzkennzahl und Grenzen | Die Auswirkung auf den Support bleibt ungewiss | 40 gegenüber 44 Nutzern mit Supportkontakt, Intervall, Toleranz und Grenzen der untersuchten Nutzergruppe |
| 6. Festgehaltene Maßnahme | Bisherigen Prozess beibehalten und nächsten Test planen | Produktverantwortliche bestätigen die Entscheidung; der Analyst entwirft die Folgestudie; die Supportleitung prüft vor einem weiteren Test die entfernten Fragen |
Fügen Sie die zugrunde liegende Analyse, Kennzahlendefinitionen und Zuteilungsdiagnostik als Begleitmaterial bei. Nicht jede Datenzeile muss auf einer Folie stehen, aber jede zentrale Zahl sollte sich auf die freigegebene Analyseversion zurückführen lassen. Wenn Sie KI zum Erstellen des Entwurfs nutzen, geben Sie „fiktives Rechenbeispiel“, beide Nenner, beide Intervalle und die Einführungsregel mit. Prüfen Sie den Folientext auf fehlende Verneinungen, veränderte Einheiten oder eine erfundene Bewertung.
Die tatsächlich begründete nächste Maßnahme festhalten
Für diesen fiktiven Test lautet der Beschluss: Den bisherigen Einrichtungsprozess beibehalten; weder eine nachgewiesene Verbesserung der Abschlussquote noch eine bestandene Supportprüfung behaupten; Analyst und Supportleitung sollen vor einer neuen Einführungsentscheidung die nächste Studie vorschlagen. Diese könnte überarbeitete Hilfetexte testen oder einen kleineren Effekt genauer untersuchen. Fragestellung, Fallzahl, Messung und Stoppregel müssen jedoch feststehen, bevor neue Ergebnisse betrachtet werden.
Die Ergebnispräsentation hat ihren Zweck erfüllt, wenn das Team erklären kann, warum es so handelt. Eine überzeugende Präsentation macht aus Unsicherheit keine Gewissheit. Sie zeigt Evidenz, wirtschaftliche Schwelle und offene Entscheidung auf derselben Seite.