Durante un incidente, las personas necesitan saber si les afecta, qué deben hacer y cuándo recibirán más información. Una presentación de comunicación del incidente ayuda al equipo a dar respuestas coherentes. No debería obligar a clientes o directivos a descifrar el canal técnico de respuesta.
Esta primera actualización para clientes corresponde a un servicio ficticio de carga de archivos adjuntos. Todos los horarios, observaciones y mensajes del ejemplo son inventados con fines ilustrativos; no describen un incidente de Presenti.
10:15 UTC — Investigación de errores al cargar archivos adjuntos
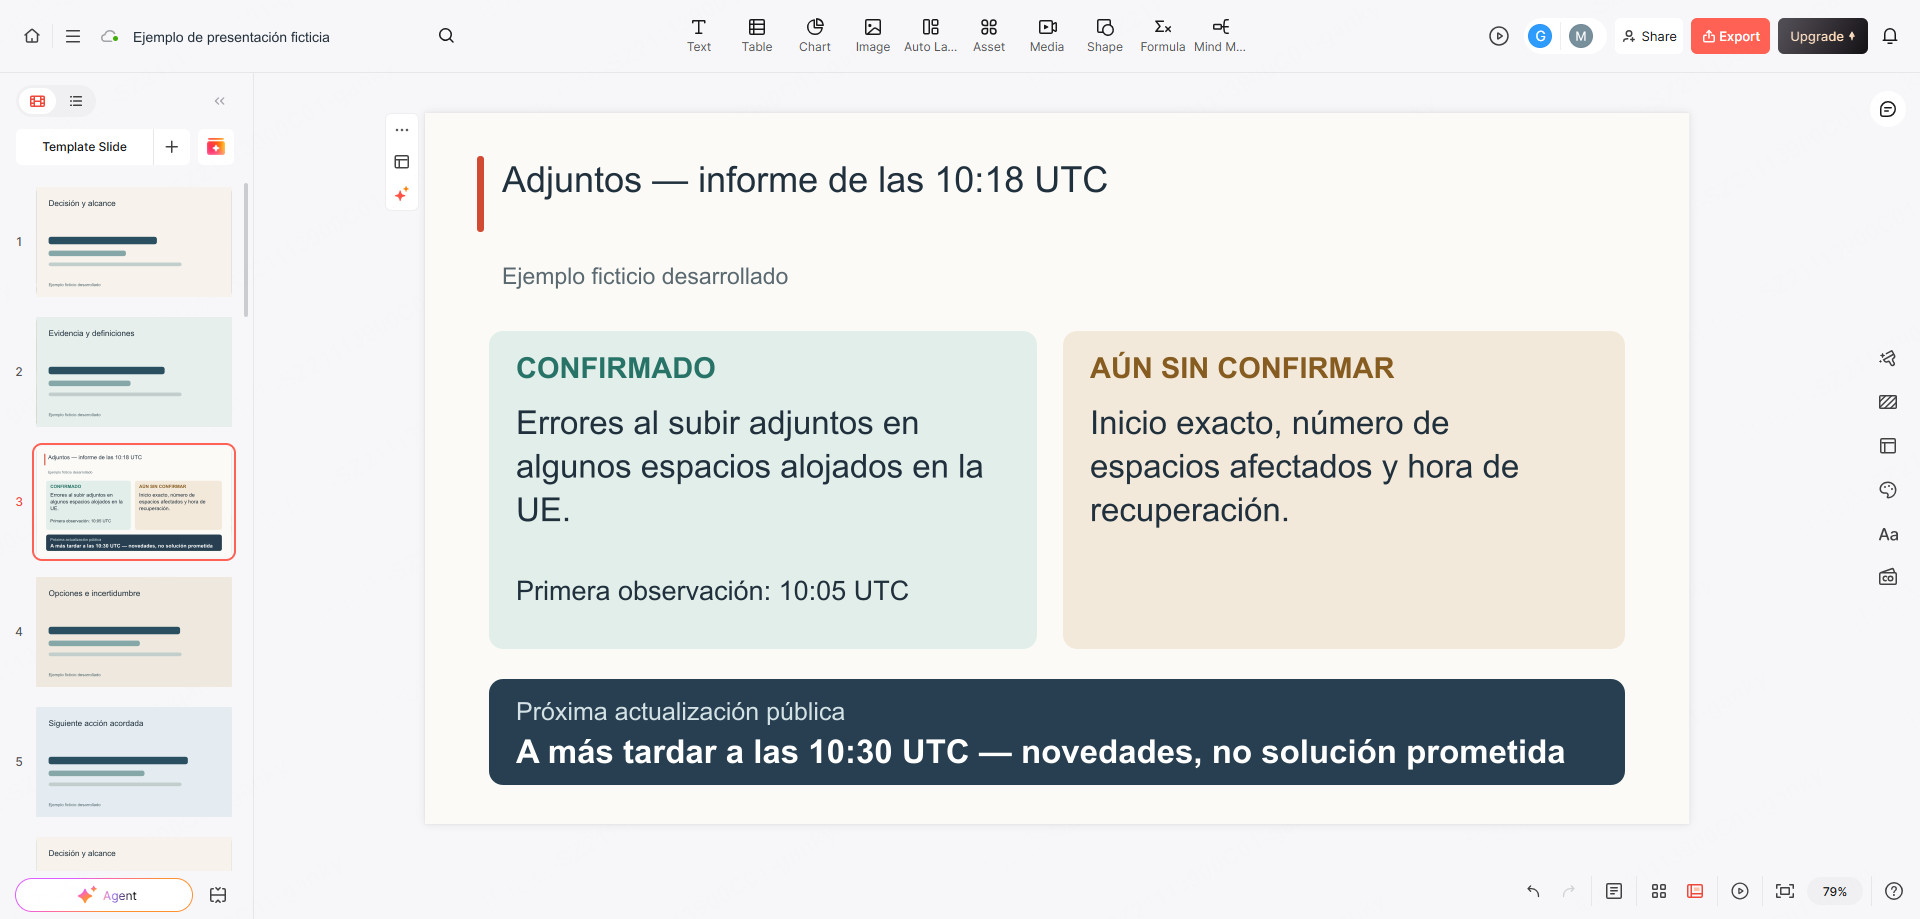
Estamos investigando errores que afectan a la carga de nuevos archivos adjuntos en algunos espacios de trabajo alojados en nuestra región de la UE. Detectamos los errores por primera vez a las 10:05 UTC y seguimos determinando el alcance completo. Publicaremos otra actualización antes de las 10:30 UTC o a esa hora.
El mensaje identifica la tarea, el alcance conocido y la próxima actualización sin inventar una causa ni una hora de recuperación. Construye el informe con esos mismos hechos confirmados. Una vez aprobadas las notas, Presenti puede ayudarte a convertir el texto en una presentación editable para informar a las partes interesadas. No monitoriza el incidente, verifica la recuperación ni publica por ti las actualizaciones de la página de estado.
Mantén un único registro de hechos detrás de los distintos mensajes
Antes de diseñar las diapositivas, prepara un breve registro del incidente que puedan consultar todas las personas que redacten actualizaciones. Cada observación necesita una hora y una fuente. Las hipótesis deben identificarse como tales. Una pregunta sin respuesta debe seguir abierta hasta que exista evidencia.
En el incidente ficticio, el registro de las 10:18 UTC podría contener lo siguiente:
| Estado | Información | Evidencia o siguiente acción |
|---|---|---|
| Confirmado | La carga de nuevos archivos adjuntos devuelve errores en algunos espacios de trabajo alojados en la UE. | Registros de errores de la pasarela y una prueba de carga fallida desde un espacio afectado; primera observación a las 10:05 UTC. |
| Confirmado, con cobertura limitada | Las descargas de archivos existentes han superado las comprobaciones realizadas hasta ahora. | Resultados de pruebas registrados; estas comprobaciones no demuestran que todas las descargas de todos los clientes funcionen correctamente. |
| Desconocido | Hora exacta de inicio y número total de espacios de trabajo afectados. | El equipo de operaciones está revisando los registros anteriores y el alcance de las peticiones fallidas. |
| Hipótesis | Podría estar relacionado con un cambio de enrutamiento. | El equipo del servicio compara el registro del cambio con los fallos observados. La coincidencia temporal no demuestra causalidad. |
| Desconocido | Si todos los intentos de carga que agotaron el tiempo de espera fallaron antes de almacenar un archivo. | Hay que conciliar los resultados de las peticiones. No afirmes a los clientes que no se han perdido datos ni que no se ha almacenado nada. |
Separa la hora exacta de inicio de la primera observación. Aquí hay evidencia para decir «Observamos errores por primera vez a las 10:05», pero no para afirmar «El incidente empezó a las 10:05». Esa distinción evita tener que corregir una afirmación categórica cuando aparecen fallos anteriores en los registros.
La presentación es una instantánea fechada de ese registro, no una fuente de verdad paralela. Añade «Situación a las 10:18 UTC» al informe interno. Si alguien lo reenvía una hora después, debe resultar evidente cuánto tiempo ha pasado desde su elaboración.
Da a cada audiencia la información que puede utilizar
La guía de Google sobre respuesta a incidentes separa las responsabilidades de coordinación del incidente, operaciones y comunicación. También reconoce que clientes, soporte, personal técnico y responsables de negocio necesitan información distinta. Utiliza esa distinción para cambiar el énfasis, no los hechos.
| Audiencia | Pregunta principal | Qué debe incluir su actualización |
|---|---|---|
| Clientes | ¿Puedo completar mi tarea y qué debo hacer? | Función y alcance afectados, acción o alternativa confirmada, estado actual y hora de la próxima actualización. |
| Soporte | ¿Cómo respondo de forma coherente y escalo información útil? | Mensaje público aprobado, síntomas que reconocer, promesas que evitar y datos de diagnóstico que solicitar. |
| Equipo de respuesta | ¿Qué sabemos, qué se está probando y quién lo hace? | Evidencia, hipótesis, acciones en curso, responsables, dependencias y decisiones técnicas pendientes. |
| Responsables de negocio | ¿Cuál es la exposición y se necesita alguna decisión por mi parte? | Impacto conocido en clientes, dimensión aún desconocida, responsables de respuesta, decisiones sobre recursos o comunicación y hora del próximo informe. |
Una actualización para clientes normalmente no necesita una teoría sobre el enrutamiento. El equipo de respuesta sí. La dirección necesita saber que todavía se está determinando el número de espacios afectados, no recibir una estimación improvisada que se convierta en cifra oficial cuando alguien reenvíe la diapositiva.
Este sería un breve mensaje interno para la dirección en el mismo informe ficticio de las 10:18:
La carga de nuevos archivos adjuntos está fallando en algunos espacios de trabajo alojados en la UE. El número de espacios afectados y la hora exacta de inicio aún no están confirmados. El equipo del servicio está investigando; la persona que coordina el incidente es responsable de las decisiones de respuesta y la responsable de comunicación coordina los mensajes para clientes y soporte. No hay una hora de recuperación aprobada para comunicar. La próxima actualización para clientes debe publicarse como máximo a las 10:30 UTC. En este momento no se solicita ninguna decisión adicional a la dirección.
Para soporte, añade una instrucción independiente: solicitar el identificador del espacio de trabajo, la hora aproximada en UTC y el mensaje de error visible a través del canal habitual de soporte. No pidas que los clientes publiquen archivos privados o credenciales en una página de estado pública. Si no hay una alternativa confirmada, dilo en lugar de sugerir pasos especulativos.
Muestra la cronología del incidente y la de sus comunicaciones
Un evento operativo y el mensaje que informa de él son registros distintos. Aplicar una mitigación a las 10:42 no significa que se informara a los clientes a esa hora ni que la recuperación estuviera verificada. Incluye ambos tipos de evento en la cronología.
| Hora | Tipo de evento | Qué recoge el registro |
|---|---|---|
| 10:05 | Observación | Primera observación de errores de carga. El inicio exacto sigue sin conocerse. |
| 10:12 | Respuesta | Se declara el incidente y se asignan las responsabilidades de coordinación y comunicación. |
| 10:15 | Actualización pública | Se comunica la investigación y se promete otra actualización como máximo a las 10:30. |
| 10:30 | Actualización pública | Aún no hay recuperación confirmada; la investigación continúa; próxima actualización como máximo a las 10:50. |
| 10:42 | Respuesta | Se aplica una mitigación. Todavía hay que comprobar su efecto. |
| 10:50 | Actualización pública | Las comprobaciones recientes muestran una mejora; se está observando el servicio; próxima actualización como máximo a las 11:15. |
| 11:15 | Actualización pública | Se declara restablecida la disponibilidad de carga tras superar las comprobaciones de recuperación acordadas. Se mantiene una vía de soporte para los problemas de clientes que sigan pendientes. |
Los intervalos son ejemplos, no una política universal. Define una frecuencia que el equipo pueda cumplir y acórtala cuando la situación lo justifique. Si hay un cambio relevante antes de la hora prometida, comunícalo sin esperar.
Prometer una actualización no es prometer una solución. Escribe «próxima actualización como máximo a las 10:50 UTC», no «estará resuelto a las 10:50», salvo que esta última afirmación tenga una base defendible y esté aprobada. Aunque la investigación no aporte una conclusión nueva, sigue existiendo el compromiso de informar.
Utiliza mensajes que sigan siendo precisos a medida que cambia el incidente
El primer aviso deja constancia pública del problema. Los siguientes mensajes muestran cómo puede avanzar el mismo incidente ficticio sin convertir indicios provisionales en certezas.
A las 10:30: la investigación continúa
10:30 UTC — La investigación continúa
Seguimos investigando los errores de carga de archivos adjuntos que afectan a algunos espacios de trabajo alojados en nuestra región de la UE. Todavía no tenemos una hora de recuperación ni una alternativa confirmadas. Publicaremos la próxima actualización antes de las 10:50 UTC o a esa hora.
Este mensaje es útil aunque no anuncie una solución. Confirma que el incidente sigue activo y evita que la hora de actualización anterior venza sin explicación. No lo rellenes con «nuestros ingenieros trabajan sin descanso» ni repitas una causa sin verificar.
A las 10:50: se comprueba la mejora
10:50 UTC — Seguimiento de la recuperación
Hemos aplicado una mitigación y las comprobaciones recientes muestran que la carga de archivos adjuntos vuelve a funcionar en la región afectada. Estamos observando los resultados antes de declarar restablecido el servicio. Si todavía recibes un error de carga, contacta con soporte e indica el identificador del espacio de trabajo y la hora aproximada. Actualizaremos esta página como máximo a las 11:15 UTC.
«Las comprobaciones muestran una mejora» tiene un alcance menor que «todo vuelve a funcionar para todos». Respeta ese límite. Que un gráfico vuelva a la normalidad no aclara por sí solo qué pasó con los intentos anteriores ni demuestra que se hayan recuperado todos los recorridos de los clientes.
A las 11:15: explica qué se ha restablecido
11:15 UTC — Disponibilidad de carga de archivos adjuntos restablecida
La carga de archivos adjuntos funciona con normalidad en la región afectada. Los resultados se han mantenido dentro del rango habitual del servicio durante el periodo de observación de la recuperación y se han superado las comprobaciones de carga acordadas. Si una carga anterior devolvió un error o no tienes claro su resultado, revisa la lista de archivos adjuntos antes de intentarlo de nuevo. Contacta con soporte si sigues teniendo problemas.
Este último mensaje supone que el equipo ficticio ya realizó esas comprobaciones y confirmó que la instrucción para el cliente es adecuada para su servicio. No lo copies en un incidente real antes de disponer de esa evidencia. No afirma una causa raíz, no cuantifica todos los clientes afectados ni hace una afirmación general sobre pérdida de datos.
Para adaptar los mensajes, sustituye la función, el alcance, el síntoma observado, el estado respaldado por evidencia, la acción del cliente y la hora de la próxima actualización. Esos campos contienen la información importante. Cambiar solo el nombre del servicio y conservar afirmaciones de recuperación sin respaldo no es una adaptación segura.
Haz visibles la aprobación y la próxima actualización
La persona responsable de comunicación necesita algo más que un párrafo terminado. El informe debe identificar quién confirma los hechos técnicos, quién aprueba el mensaje público y quién lo publica por el canal autorizado. Utiliza los roles reales del incidente; no supongas que quien redacta la diapositiva puede autorizar una declaración de recuperación.
Para el servicio ficticio bastaría un informe de cinco diapositivas:
- Estado actual: función y región afectadas, hora de referencia y responsable actual del incidente.
- Impacto e incertidumbre: qué está confirmado, qué sigue sin saberse y de dónde procede cada afirmación importante.
- Respuesta: acciones en curso y decisiones necesarias, sin presentar una hipótesis sin probar como causa.
- Comunicación: mensaje aprobado para clientes, nota de soporte, responsable de publicación y hora de la próxima actualización.
- Evidencia de recuperación: comprobaciones necesarias para pasar de investigación a seguimiento o restablecimiento, junto con sus resultados reales cuando estén disponibles.
Distingue de forma visible el texto en borrador del ya enviado. Registra la versión, las horas de aprobación y publicación y el destino. Si el equipo reduce el alcance de «región de la UE» a un conjunto más concreto de espacios, actualiza conjuntamente el registro compartido y los mensajes posteriores, en lugar de dejar diapositivas contradictorias en circulación.
La guía de Google para gestionar incidentes destaca la importancia de mantener un registro actualizado y hacer un traspaso claro. Para esta presentación, la consecuencia práctica es sencilla: la persona responsable y la hora de referencia deben seguir visibles, especialmente cuando cambia el equipo que lleva la respuesta.
Separa el restablecimiento del servicio de la explicación posterior
Durante la recuperación, comunica qué función vuelve a estar disponible y qué acciones siguen teniendo que realizar los clientes. No esperes a terminar todo el análisis causal para informar del restablecimiento. Tampoco ocultes un impacto que continúa bajo la etiqueta «resuelto» solo porque una métrica del sistema haya mejorado.
Después del incidente, el equipo puede investigar factores contribuyentes y cambios a largo plazo en una presentación de análisis posterior al incidente. Es otro entregable. El informe activo no debería inventar una causa raíz para que el relato parezca completo.
Si la persona responsable de comunicación hace el relevo antes de la resolución, debe dejar un registro utilizable. Este es el traspaso ficticio de las 10:35 UTC, entre la actualización de investigación y la de seguimiento:
Traspaso de comunicación — 10:35 UTC
Estado público actual: investigación de errores de carga de archivos adjuntos en algunos espacios de trabajo alojados en la UE. Último mensaje: versión 2, publicado a las 10:30 UTC. Próxima actualización pública: como máximo a las 10:50 UTC; si la recuperación no está confirmada, se publicará igualmente un mensaje sin novedades concluyentes. La persona entrante ha aceptado la responsabilidad de comunicación. Quien coordina el incidente confirma el estado operativo y la persona responsable de comunicación publica el texto aprobado. La hora de recuperación, el inicio exacto y el número de espacios afectados siguen sin confirmarse. El registro compartido contiene la evidencia más reciente y el mensaje para soporte.
La persona entrante ya puede enviar la siguiente actualización precisa sin reconstruir el incidente a partir del historial del chat ni adivinar qué diapositiva está vigente.