Una presentación de análisis posterior a un incidente debe explicar qué experimentaron los usuarios, cómo se restableció el servicio, qué indican las pruebas sobre el fallo y qué cambios conviene abordar. No hace falta reproducir todos los mensajes del canal de incidencias. Tampoco conviene que unas diapositivas bien ordenadas den por resuelta una causa que sigue investigándose.
Parte del registro revisado del incidente. La presentación debe facilitar la discusión de distinciones importantes: tareas afectadas y personas afectadas, recuperación del servicio y resolución del trabajo pendiente, hechos observados y explicaciones. El ejemplo siguiente muestra cómo trasladarlas a las diapositivas.
Define qué debe resolver la reunión
Antes de preparar las diapositivas, escribe la pregunta que debe responder la reunión. Para un equipo responsable de un servicio podría ser: «¿Entendemos el fallo lo suficiente como para reanudar este despliegue y qué tareas deben hacerse primero?». Una revisión dirigida a clientes puede necesitar otra explicación: el impacto y la próxima comunicación. Utiliza la versión aprobada para ese público.
La guía de SRE de Google, en inglés, describe los análisis posteriores a incidentes como registros del impacto, las medidas de mitigación, las causas y las acciones posteriores. Pone el foco en las condiciones que influyeron en las decisiones, en lugar de buscar culpables. Para preparar la presentación, reúne primero el registro y después explica lo que contiene. Las diapositivas no sustituyen la investigación.
Si necesitas comunicar avances habituales, utiliza una estructura de informe semanal, en inglés. Incluir una actualización completa de estado dentro del análisis puede ocultar las preguntas que el incidente deja abiertas.
Ejemplo: se interrumpe la generación de informes y después se resuelve la cola
Imagina este caso ficticio de un servicio que prepara informes descargables. Todas las horas corresponden a una misma fecha y están expresadas en UTC.
| Hora | Qué consta en el registro | Fuente que habría que conservar en un caso real |
|---|---|---|
| 09:00 | Comienza un despliegue. También aparecen los primeros fallos registrados en tareas de generación de informes. | Registro del despliegue y logs de las tareas, indicando la precisión de los relojes. |
| 09:04 | Una alerta avisa al equipo de guardia de que hay tareas fallando. | Evento de alerta y registro de entrega del aviso. |
| 09:12 | El equipo comienza a revertir el despliegue. | Registro del incidente y de la reversión. |
| 09:27 | La monitorización muestra que las nuevas tareas vuelven a completarse con normalidad. | Comprobación de recuperación e intervalo observado. |
| 10:00 | La conciliación de registros confirma que las 180 tareas afectadas identificadas figuran como completadas. | Comprobación tarea por tarea, con el tratamiento de los reintentos. |
Las notas indican que los procesos de ejecución registraron un estado no reconocido durante el fallo. Todavía no permiten determinar qué componente lo introdujo ni por qué las comprobaciones previas no lo detectaron. Hay 180 identificadores de tareas distintos, pero no un recuento verificado de clientes distintos ni un cálculo del impacto comercial.
Con eso ya puede prepararse una revisión útil, sin rellenar los huecos. Mantén disponibles las referencias a los logs; no pegues datos sensibles de las solicitudes, tokens de acceso ni información de clientes en una diapositiva que se va a proyectar.
Distingue la recuperación del servicio del trabajo pendiente
Un titular tentador sería: «Una caída de 27 minutos afectó a 180 clientes». Hay que corregir ambas partes. El ejemplo documenta fallos en tareas de generación de informes, no una caída de todo el servicio, y cuenta tareas, no personas. Una misma persona podría haber enviado varias.
Una formulación más precisa sería: «Se observaron fallos en la generación de informes durante 27 minutos; a las 10:00 se había verificado la finalización de las 180 tareas afectadas identificadas». Debajo, muestra los dos intervalos:
- 09:00–09:27: desde el primer fallo registrado hasta que las nuevas tareas vuelven a completarse con normalidad.
- 09:27–10:00: los 33 minutos adicionales hasta terminar la comprobación de las tareas afectadas.
El segundo intervalo importa a quien sigue esperando un informe, aunque las nuevas solicitudes ya funcionen. No atribuyas una hora de retraso a todas las tareas: para calcularlo harían falta sus horas individuales de envío y finalización. Del mismo modo, «tareas completadas» no demuestra que el contenido de cada informe sea correcto ni que no se hayan perdido datos.
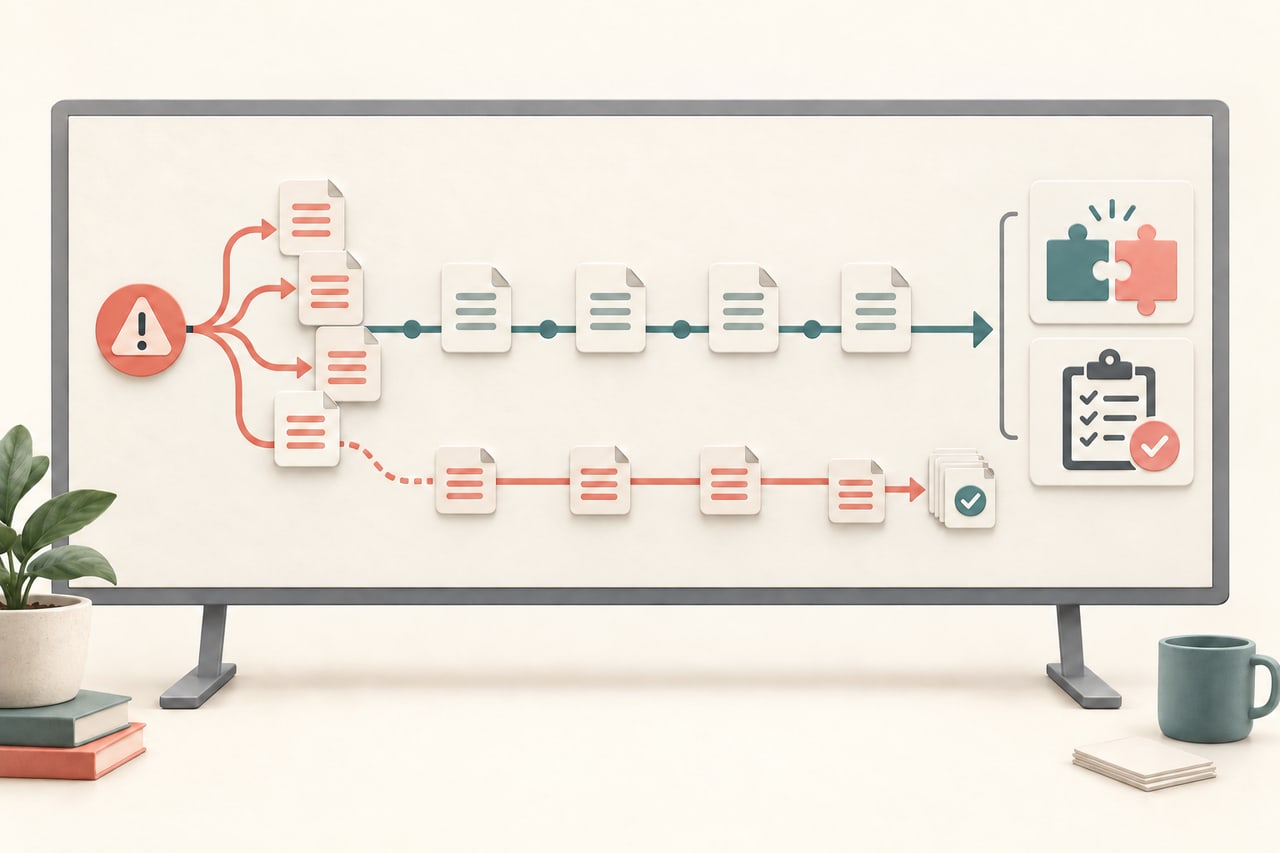
Utiliza una cronología horizontal con marcas distintas para la recuperación y la resolución de la cola. Indica la zona horaria junto al eje. Si en un incidente real la hora del primer fallo es estimada, muestra esa incertidumbre; no la sustituyas por la hora del despliegue solo porque esté disponible.
Organiza siete diapositivas alrededor de las pruebas
Para este incidente, siete diapositivas son un punto de partida razonable. Utiliza menos si los hechos son sencillos y añade material de apoyo cuando haya que examinar un punto discutido.
- Qué ocurrió y qué requiere atención. Delimita el impacto, explica el estado actual del servicio y señala qué decisión sobre el despliegue sigue pendiente.
- A quién o a qué afectó. Muestra las 180 tareas distintas, el proceso afectado y la falta de un recuento de clientes. No sustituyas un dato desconocido por una estimación que parezca plausible.
- Cómo transcurrió el incidente. Presenta las cinco horas registradas, distinguiendo alerta, reversión, recuperación y resolución del trabajo pendiente.
- Qué explican las pruebas disponibles. Coloca la observación del estado no reconocido junto a la pregunta que se investiga. La secuencia de reversión es relevante, pero por sí sola no establece todo el mecanismo del fallo.
- Qué ayudó y qué ralentizó la respuesta. Comenta información, herramientas o problemas de coordinación concretos que consten en el registro. No inventes «lecciones aprendidas» para equilibrar la diapositiva.
- Qué cambios se proponen. Distingue las medidas preventivas de las mejoras de respuesta, con una persona o equipo responsable y una forma de comprobar su ejecución.
- Qué debe decidir el grupo. Confirma prioridades, pruebas aún pendientes y condiciones para reconsiderar el despliegue.
Deja los logs detallados, las condiciones de las pruebas y las definiciones de conciliación en el material de apoyo. Un resumen ejecutivo, explicado en esta guía en inglés, puede orientar a un público más amplio, siempre que mantenga la diferencia entre la recuperación del procesamiento y el impacto que aún sufrían los usuarios.
Explica la causa sin dar por cerrada la investigación
«Alguien desplegó un cambio defectuoso» no ayuda al siguiente ingeniero a reconocer o prevenir el fallo. Además, omite las preguntas del ejemplo: qué versiones del componente productor y de los procesos de ejecución estaban activas, qué estados entendían y qué cubrían las pruebas previas.
Divide la diapositiva en lo observado, la explicación propuesta y las pruebas que faltan. Aquí se ha observado un error de estado no reconocido. Una posible incompatibilidad sigue siendo una hipótesis hasta que la comparación de versiones y una reproducción del fallo la respalden. El siguiente paso útil es contrastar esas versiones e intentar reproducir el caso en un entorno de prueba adecuado.
Si dos fuentes discrepan sobre una hora, conserva ambos registros mientras aclaras la diferencia. Si alguien cuestiona la causa, limita el titular a lo demostrado. La presentación puede servir para decidir que la investigación continúe; no necesita una explicación causal definitiva para que la reunión tenga sentido.
Propón acciones más concretas que «tener más cuidado»
Estas son propuestas para discutir en el caso ficticio, no correcciones ya realizadas ni compromisos aceptados:
| Cambio propuesto | Pregunta que aborda | Cómo comprobar su ejecución |
|---|---|---|
| Añadir una prueba de compatibilidad entre las versiones implicadas del productor y del ejecutor. | ¿Puede el proceso de publicación detectar este fallo antes del despliegue? | Una prueba documentada que reproduzca el rechazo del estado con la combinación defectuosa y registre el comportamiento esperado con la combinación corregida. |
| Añadir al procedimiento del incidente un apartado sobre recuperación y resolución de la cola. | ¿Puede el equipo distinguir las nuevas tareas que ya funcionan de las tareas afectadas aún pendientes? | Un procedimiento revisado y un ensayo que registre por separado recuperación, conciliación y tareas sin resolver. |
Pide a los equipos implicados que acuerden responsables, prioridad y fechas. No asignes una acción a un ingeniero solo porque fue el primero en responder. Evita «esto no volverá a pasar»: ni una prueba ni un procedimiento permiten afirmarlo. Explica qué fallo o retraso concreto pretende abordar cada acción.
Prepara el borrador en Presenti a partir del registro revisado
Prepara un documento sin información sensible con la definición del impacto, cronología, referencias, hechos establecidos, preguntas abiertas y acciones propuestas. Utilízalo en el flujo de texto a presentación de Presenti para redactar la secuencia de siete diapositivas. Pide que conserve las marcas de las 09:27 y las 10:00 por separado y deje sin determinar el número de clientes.

Revisa el esquema antes de elegir el estilo visual. Si el borrador convierte «posible incompatibilidad» en «causa raíz confirmada», corrígelo antes de generar diapositivas más elaboradas. Deja espacio para leer las etiquetas de la cronología y sitúa la prueba de ejecución junto a cada acción propuesta. Presenti puede organizar la explicación; no puede validar los logs ni decidir si es seguro reanudar el despliegue.
Descarga el documento de trabajo y el esquema de siete diapositivas, o utiliza esta instrucción:
Prepara un borrador de revisión del incidente a partir del registro proporcionado. Distingue impacto, detección, reversión, recuperación de nuevas tareas y conciliación de las tareas afectadas. Separa observaciones e hipótesis. Conserva los datos desconocidos, las referencias y las zonas horarias. No inventes clientes afectados, pérdidas económicas, causas, responsables que hayan aceptado acciones ni acciones completadas.
Termina la reunión registrando lo que realmente se ha acordado y qué pruebas siguen pendientes. Lleva esos puntos concretos a la siguiente revisión. El resultado útil es entender mejor el incidente y decidir con fundamento qué cambiar, no una diapositiva que declare imposible su repetición.