障害が起きたとき、関係者が知りたいのは、自分に影響があるのか、何をすべきか、次の情報はいつ届くのかです。障害発生中の状況共有資料は、チームが一貫した回答をするために使います。顧客や経営層に、技術者向けの対応チャットを読み解いてもらう資料ではありません。
まず、架空の添付ファイルアップロードサービスで使う、顧客向けの初報を見てみましょう。以下の時刻、観測内容、メッセージはすべて説明用の架空例であり、Presentiで発生した障害ではありません。
10:15 UTC — 添付ファイルのアップロードエラーを調査中
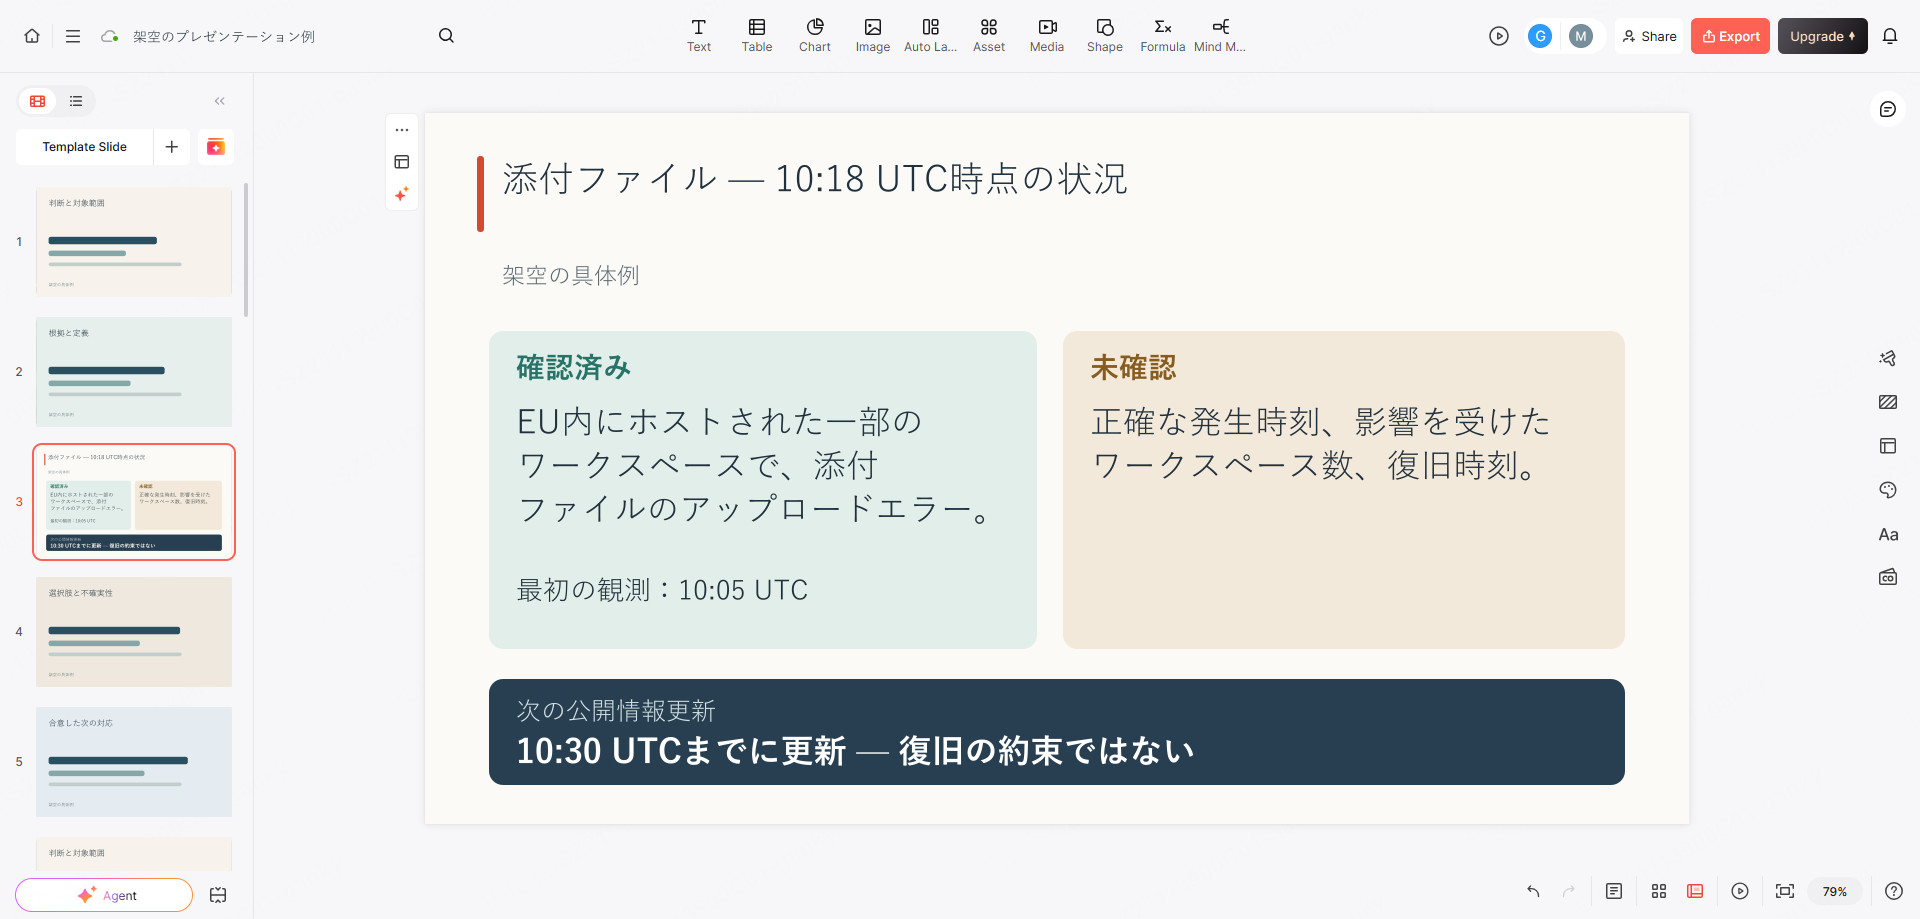
EUリージョンでホストされている一部のワークスペースで、新しい添付ファイルをアップロードする際にエラーが発生しており、調査を進めています。エラーを最初に確認したのは10:05 UTCで、現在も影響範囲を確認中です。次の情報は10:30 UTCまでにお知らせします。
このメッセージは、原因や復旧時刻を推測せず、影響のある操作、判明している範囲、次の更新時刻を示しています。資料も、同じ確認済みの事実を土台に作ります。メモの内容が承認されたら、Presentiでテキストを編集可能なプレゼン資料にまとめることで、関係者向けの説明に使えます。Presentiが障害を監視したり、復旧を検証したり、ステータスページの情報を代理で公開したりするわけではありません。
複数のメッセージの背後に、共通の事実記録を置く
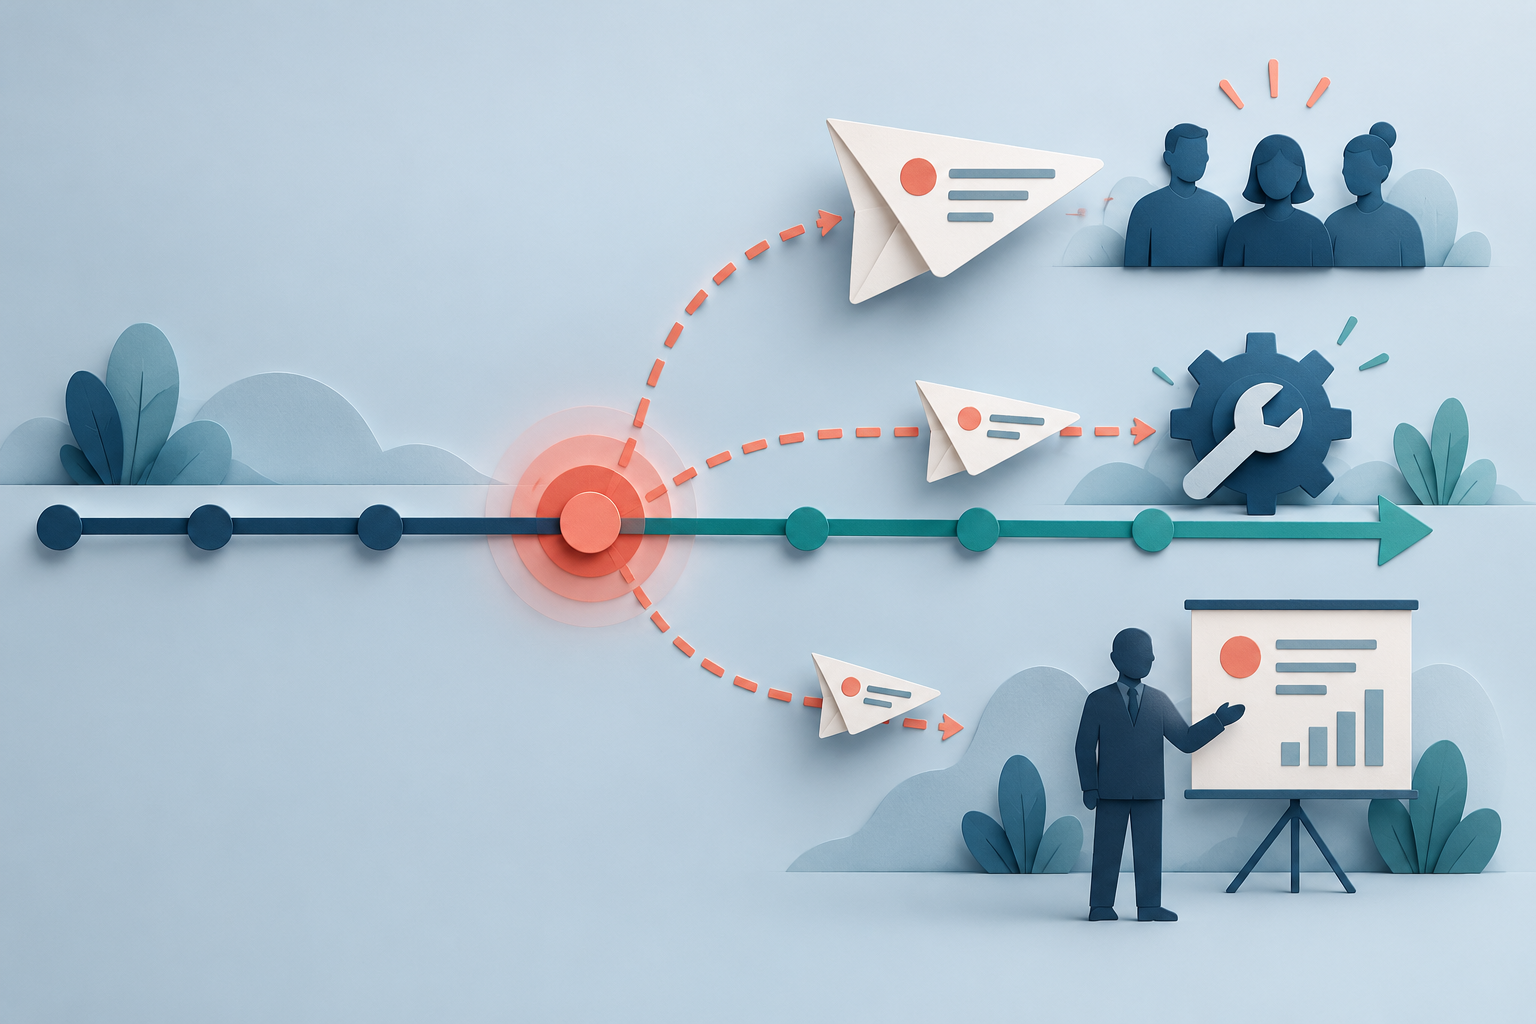
スライドをデザインする前に、情報発信に関わる全員が使える短い障害記録を作ります。観測事項には時刻と情報源を付けます。仮説は仮説と明記します。答えの出ていない問いは、証拠が得られるまで未確認のままにします。
架空の障害における10:18 UTC時点の記録は、次のようになります。
| 状態 | 内容 | 根拠または次の確認 |
|---|---|---|
| 確認済み | EUでホストされている一部のワークスペースで、新しい添付ファイルのアップロードがエラーになる。 | ゲートウェイのエラー記録と、影響のあるワークスペースで失敗したアップロード試験。最初の確認は10:05 UTC。 |
| 確認済みだが範囲は限定 | 既存ファイルのダウンロードは、これまで実施した確認では成功している。 | 記録された試験結果。ただし、すべての顧客によるすべてのダウンロードに影響がないと証明したわけではない。 |
| 未確認 | 正確な発生時刻と、影響を受けたワークスペースの総数。 | 運用担当が過去の記録と失敗リクエストの範囲を調べている。 |
| 仮説 | ルーティング変更が関係している可能性がある。 | サービス担当が変更履歴と観測した失敗を比較中。時刻が近いだけでは因果関係は分からない。 |
| 未確認 | タイムアウトしたアップロードが、すべてファイル保存前に失敗したのか。 | リクエスト結果の突き合わせが必要。「データ損失はない」「何も保存されていない」とは顧客に伝えない。 |
正確な発生時刻と、最初に観測した時刻は分けます。この例で裏付けがあるのは「10:05に初めてエラーを観測した」であり、「10:05に障害が始まった」ではありません。区別しておけば、後からそれ以前の失敗がログに見つかっても、断定した説明を修正せずに済みます。
プレゼン資料は、その記録を特定時点で切り出したものです。別の正本を作るわけではありません。内部向け資料には「10:18 UTC時点」と書きます。1時間後に転送されても、情報の古さが分かるようにしてください。
相手が行動に使える情報を渡す
Googleのインシデント対応ガイドでは、対応の指揮、運用作業、コミュニケーションの役割を分けています。また、顧客、サポート、技術者、経営層では必要な情報が異なるとしています。相手に合わせて変えるのは重点であって、事実ではありません。
| 相手 | 主に知りたいこと | 更新情報に含める内容 |
|---|---|---|
| 顧客 | 自分の操作はできるのか。何をすればよいか。 | 影響する機能と範囲、確認済みの対応や回避策、現在の状況、次の更新時刻。 |
| サポート | 一貫した回答をし、有用な報告をどう引き継ぐか。 | 承認済みの公開文、把握すべき症状、約束してはいけないこと、収集する診断情報。 |
| 対応チーム | 何が分かり、何を試し、誰が担当しているか。 | 証拠、仮説、実施中の対応、担当者、依存関係、未決の技術判断。 |
| 事業責任者・経営層 | 影響の大きさはどの程度か。自分の判断が必要か。 | 判明した顧客影響、未確認の規模、対応責任者、リソースや発信に関する判断事項、次の報告時刻。 |
顧客向けの更新には、通常、ルーティングに関する仮説は不要です。一方、対応チームには必要です。経営層には、影響ワークスペース数を確認中であることを伝えます。概算を思いつきで書き、転送されたスライドから公式な数字として広まるのは避けたいところです。
同じ10:18の架空の状況を、経営層向けの短い内部メッセージにすると次のようになります。
EUでホストされている一部のワークスペースで、新しい添付ファイルのアップロードが失敗しています。影響を受けたワークスペース数と正確な発生時刻は未確認です。サービス担当が調査を進め、インシデント指揮担当が対応方針を判断し、コミュニケーション担当が顧客とサポートへの案内を調整しています。対外的に伝えられる復旧見込み時刻は承認されていません。次の顧客向け更新は10:30 UTCまでに行います。現時点で、経営層に追加の判断は求めていません。
サポート向けには、通常の問い合わせ窓口を通じて、ワークスペースID、UTCでのおおよその時刻、画面のエラーメッセージを確認するよう別途指示します。公開ステータスページに非公開ファイルや認証情報を投稿するよう求めてはいけません。確認済みの回避策がなければ、推測の手順を案内せず、その旨を伝えます。
障害の時系列と、情報発信の時系列を分けて示す
運用上の出来事と、それを伝えたメッセージは別の記録です。10:42に緩和策を適用しても、10:42に顧客へ連絡したことや、その時点で復旧確認が済んだことにはなりません。資料の時系列には両方を載せます。
| 時刻 | 種類 | 記録する内容 |
|---|---|---|
| 10:05 | 観測 | アップロードエラーを初めて観測。正確な発生時刻は未確認。 |
| 10:12 | 対応 | インシデントを宣言し、指揮担当とコミュニケーション担当を決定。 |
| 10:15 | 公開情報 | 調査中であることを告知し、次回は10:30までに更新すると案内。 |
| 10:30 | 公開情報 | 復旧は未確認で調査継続。次回は10:50までに更新すると案内。 |
| 10:42 | 対応 | 緩和策を適用。効果の検証はこれから行う。 |
| 10:50 | 公開情報 | 直近の確認で改善が見られ、監視を継続中。次回は11:15までに更新すると案内。 |
| 11:15 | 公開情報 | 合意した復旧確認を終え、アップロード機能の復旧を告知。解決していない顧客の問題に対応するサポート窓口は引き続き案内。 |
この間隔は一例であり、すべての障害に適用する運用方針ではありません。対応チームが実際に守れる頻度を決め、状況に応じて間隔を短くします。約束した時刻より前に重要な変化があれば、待たずに知らせます。
更新の約束は、復旧の約束ではありません。「次の更新は10:50 UTCまで」と書き、「10:50までに復旧」とは書かないでください。後者を伝えるには、説明できる根拠と承認が必要です。調査から新しい結論が得られていなくても、更新すると約束したことは変わりません。
状況が変わっても正確さを保てる更新文を使う
最初の告知は、問題が発生していることを公開記録に残します。続く例では、暫定的な証拠を確定情報に変えてしまうことなく、同じ架空の障害の進行を伝えます。
10:30:調査を継続している場合
10:30 UTC — 調査を継続中
EUリージョンでホストされている一部のワークスペースにおける、添付ファイルのアップロードエラーを引き続き調査しています。復旧見込み時刻と回避策は、いずれもまだ確認できていません。次の情報は10:50 UTCまでにお知らせします。
修正を告知できなくても、この更新には意味があります。障害対応が継続中であることが分かり、前の更新予定時刻を何の説明もなく過ぎることを防げます。「技術者が懸命に作業しています」といった表現で埋めたり、未確認の原因を繰り返したりする必要はありません。
10:50:改善を確認している場合
10:50 UTC — 復旧状況を監視中
緩和策を適用し、直近の確認では、影響を受けたリージョンで添付ファイルのアップロードが再び成功しています。復旧を確定する前に、アップロード結果を引き続き監視しています。まだエラーが出る場合は、ワークスペースIDとおおよその時刻を添えてサポートにご連絡ください。このページは11:15 UTCまでに更新します。
「確認した範囲で改善している」は、「全員が使えるようになった」より限定的な表現です。その違いを保ってください。グラフが通常の範囲に戻っただけでは、以前の試行の結果や、すべての顧客の操作が復旧したかまでは分かりません。
11:15:何が復旧したのかを説明する
11:15 UTC — 添付ファイルのアップロード機能が復旧
影響を受けたリージョンで、添付ファイルを正常にアップロードできる状態になりました。復旧確認の観測期間中、アップロード結果は通常の範囲で推移し、合意していた確認項目もすべて通過しました。以前のアップロードでエラーが出た場合や結果が分からない場合は、再試行の前に添付ファイルの一覧をご確認ください。問題が続く場合はサポートへご連絡ください。
この最後のメッセージは、架空のチームが確認を完了し、案内する操作がそのサービスに適切であることも確かめた前提です。実際の障害では、その証拠が得られる前に転用してはいけません。原因の断定、影響を受けた顧客全体の人数、データ損失に関する一括した保証は含めていません。
自分のサービス向けに使う際は、機能、範囲、観測した症状、証拠に基づく状態、顧客が取る行動、次の更新時刻を置き換えます。意味を担うのはこれらの項目です。サービス名だけを変え、裏付けのない復旧表現を残すのは適切な転用ではありません。
承認者と次の更新を資料で見えるようにする
コミュニケーション担当には、完成した文章だけでなく、技術的な事実を誰が確認し、公開文を誰が承認し、認められた経路で誰が公開するかも必要です。実際のインシデント対応の役割に合わせてください。スライドを書いた人が復旧宣言まで承認できるとは限りません。
架空のサービスなら、状況共有用の資料は5枚にまとめられます。
- 現在の状況:影響のある機能とリージョン、基準時刻、現在の対応責任者。
- 影響と不確実性:確認済み事項、未確認事項、重要な説明の情報源。
- 対応:実施中の作業と必要な判断。未検証の仮説を原因として扱わない。
- コミュニケーション:承認済みの顧客向け文面、サポート向けメモ、公開担当、次の更新時刻。
- 復旧の根拠:調査中から監視中、復旧済みへ移るための確認事項と、判明した時点での実際の確認結果。
下書きと送信済みの文面は明確に区別します。バージョン、承認時刻、公開時刻、公開先を記録してください。影響範囲が「EUリージョン」から一部のワークスペースへ絞られた場合は、共有記録とその後のメッセージをまとめて更新し、矛盾したスライドを流通させないようにします。
Googleのインシデント管理ガイドでは、最新の状態を記録し、明確に引き継ぐことを重視しています。資料でも、担当者と基準時刻を常に見えるようにしておきます。特に、対応を引き継ぐ場面では欠かせません。
サービスの復旧と、後日の原因説明を分ける
復旧段階では、どの機能が再び使えるのか、顧客にまだ必要な操作があるのかを伝えます。原因分析がすべて終わるまで復旧の案内を待つ必要はありません。一方、システムの指標が1つ改善しただけで、続いている顧客影響を「解決済み」の表示で隠してはいけません。
障害後には、障害の振り返り資料で寄与した要因や長期的な改善を検討できます。それは別の成果物です。対応中の状況共有資料に、話を完結させるための架空の原因説明を入れるべきではありません。
解決前にコミュニケーション担当が交代するなら、次の人が使える記録を残します。調査継続の告知と監視中の告知の間にあたる、10:35 UTCの架空の引き継ぎは次のとおりです。
コミュニケーション引き継ぎ — 10:35 UTC
現在の公開状況:EUでホストされている一部のワークスペースで、添付ファイルのアップロードエラーを調査中。最新のメッセージはバージョン2で、10:30 UTCに公開済み。次の公開更新は10:50 UTCまで。復旧が確認できなくても、状況に変化がないことを含めて更新する。後任のコミュニケーション担当は引き継ぎを了承済み。運用状態はインシデント指揮担当が確認し、承認済みの文面をコミュニケーション担当が公開する。復旧時刻、正確な発生時刻、影響ワークスペース数は引き続き未確認。最新の証拠とサポート向けの文面は、共有インシデント記録に保存している。
これで後任は、チャット履歴から障害の経緯を組み立て直したり、どのスライドが最新版か推測したりせず、次の正確な更新を発信できます。